你有没有过这种时候:刷到一堆“LLM工程师速成”“3天搞定大模型”的标题,点进去全是术语堆砌、环境配置、报错截图?
你连conda怎么装都还没搞明白,文档里已经让你先配好CUDA 12.4和PyTorch 2.3——更别说那行红色警告:“请确保GPU显存≥24GB”。
你关掉页面,默默打开某知识付费平台,发现最便宜的入门课也要399元,还只教怎么调API……
而真正动手改模型、换格式、搭界面时,又得单独买云GPU、下几十GB权重、反复重装依赖库。
不是你学不会,是门槛被堆太高了。一条命令没敲对,就得花半天查Stack Overflow。
它替你省掉了什么
它不替代某款具体付费软件,但它直接砍掉了你本该花在三件事上的钱和时间:买课、租GPU、试错调试。
市面上主流的LLM入门课,单门定价普遍在299–699元之间;而云GPU按小时计费,Colab Pro每月10美元起,RunPod起步价也得自己充钱。
这个课程所有实操环节,都预置好了可直接运行的Google Colab链接。每个Notebook顶部都标着“Free tier compatible”,意味着用谷歌账号免费登录后,点开就能跑。
不需要你手动 pip install 任何包,也不需要 clone 整个仓库——Colab环境已预装好 Transformers、Accelerate、bitsandbytes 等核心库。
不用装Python,不用配环境,不用买GPU,你只需要一个能上网的浏览器。
它把“学大模型”这件事,从“先折腾两周环境,再开始学”拉回到“今天下午三点打开链接,四点就跑通第一个微调”。价格直接砍到零。
核心功能
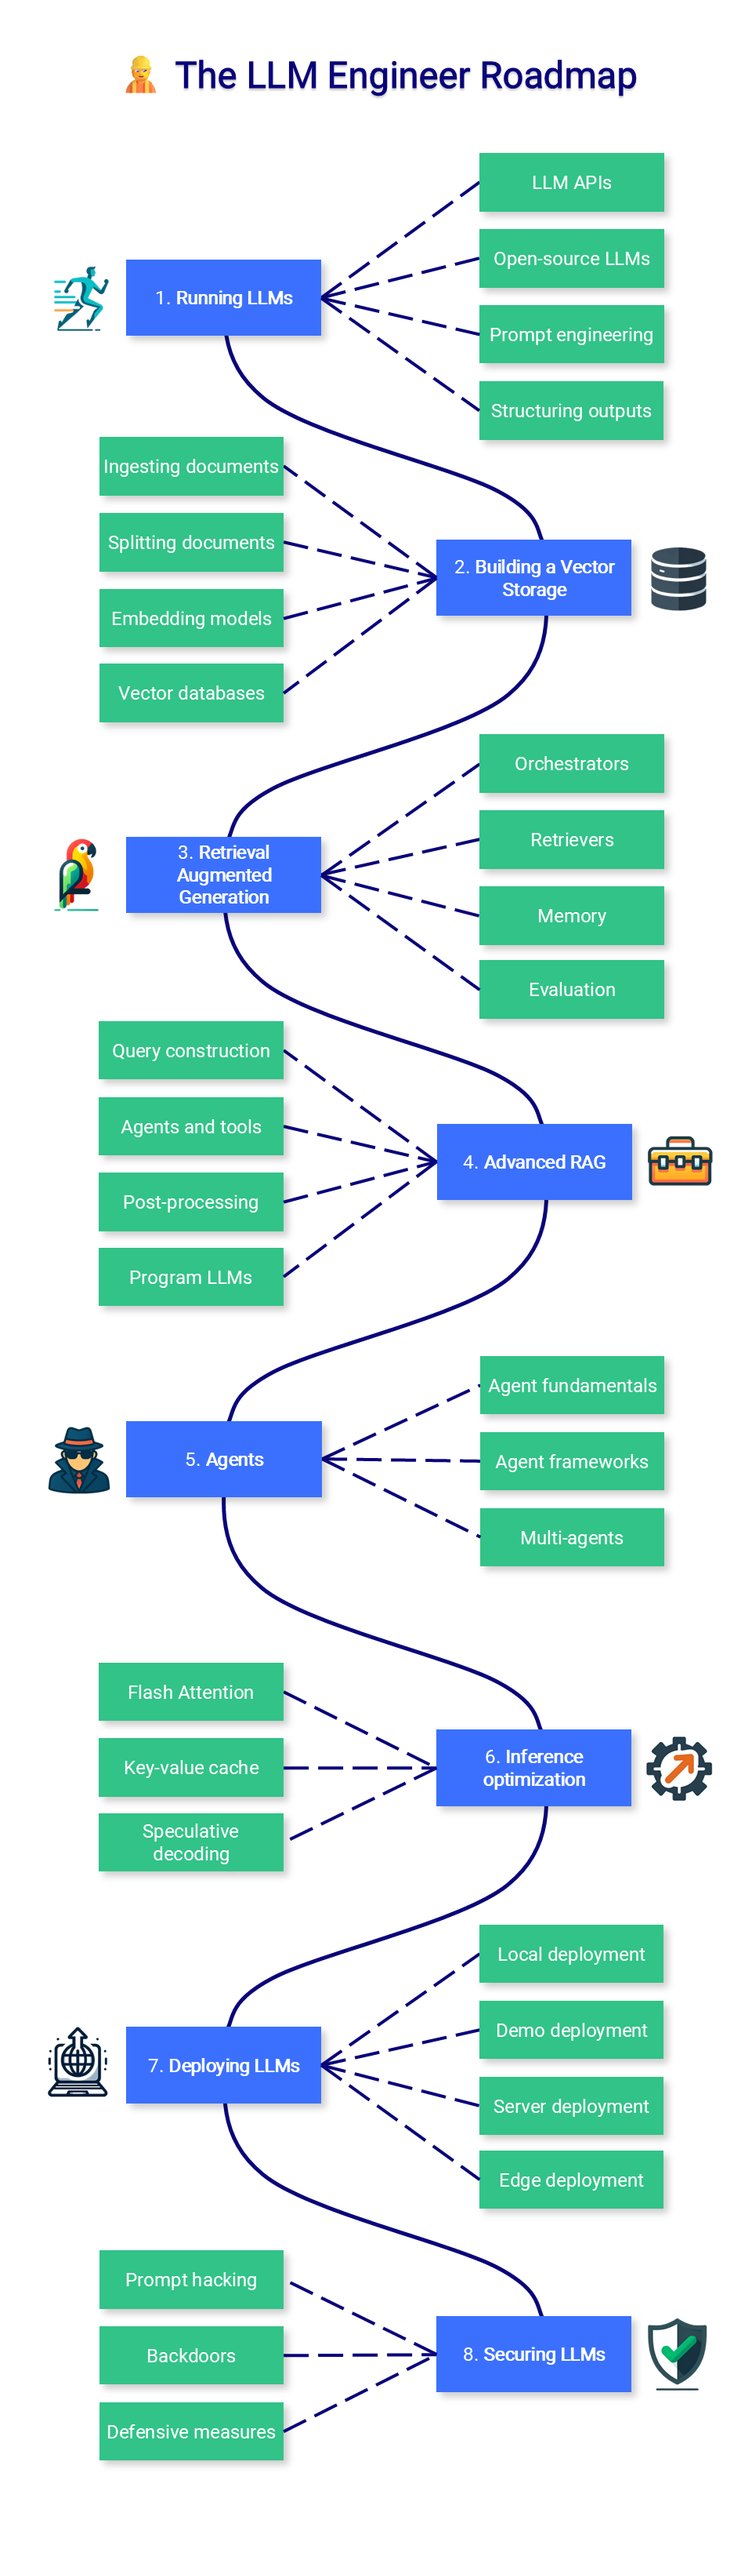
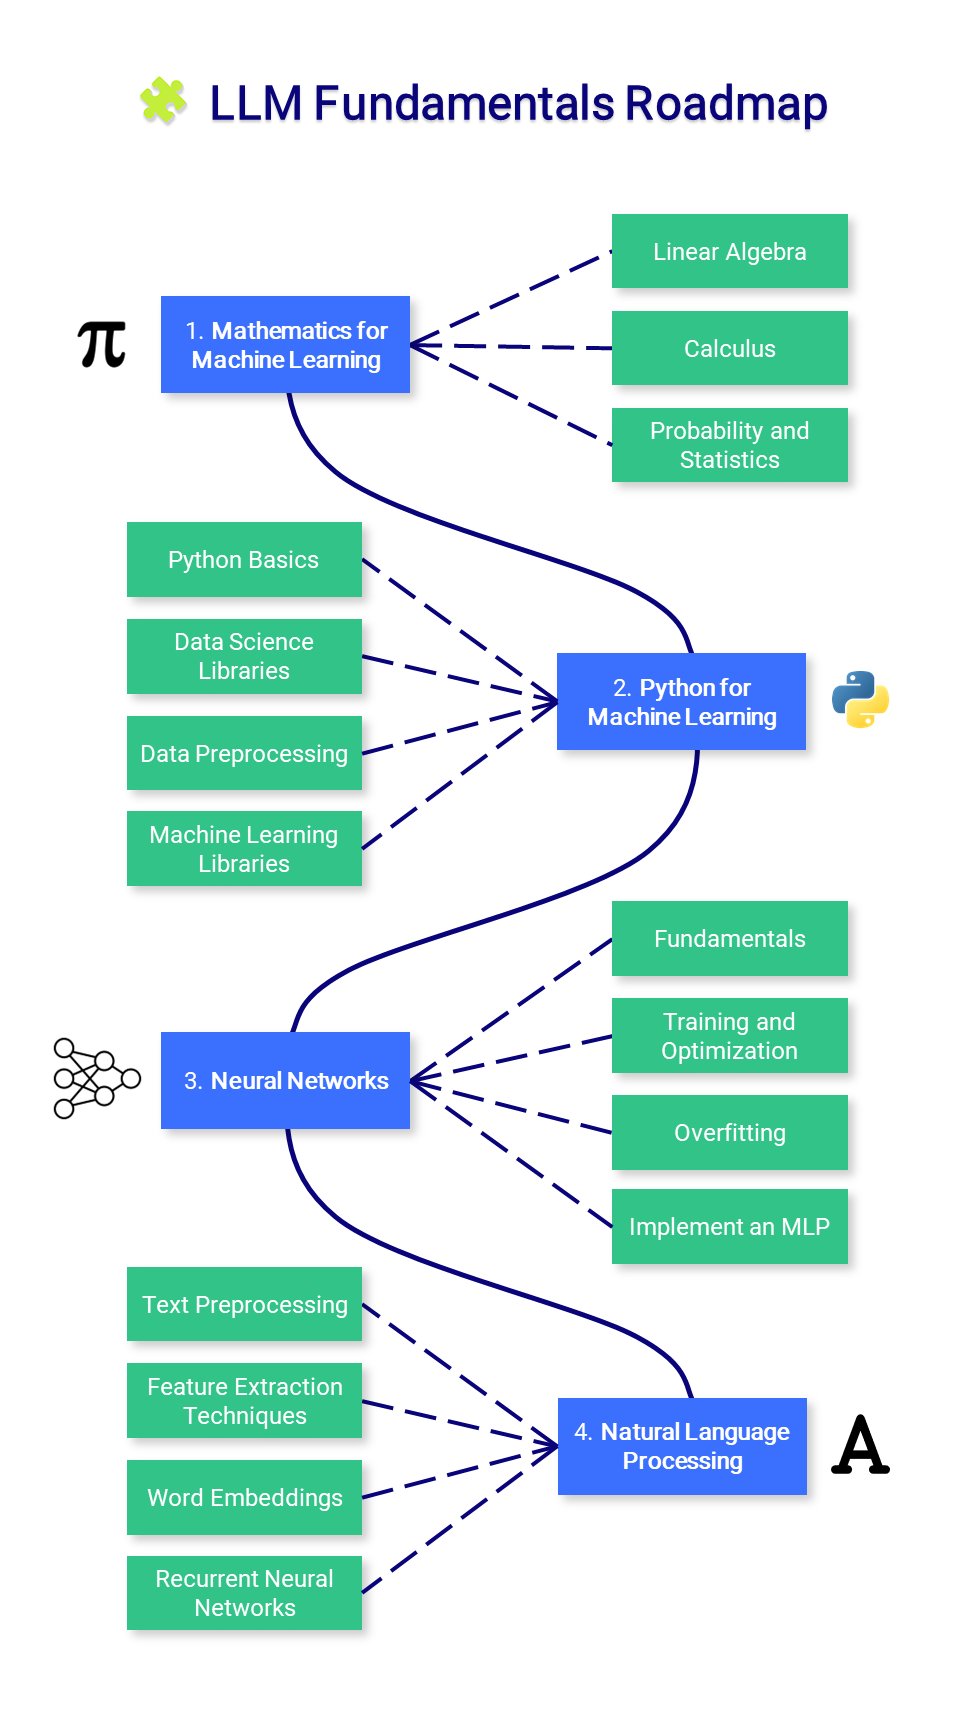
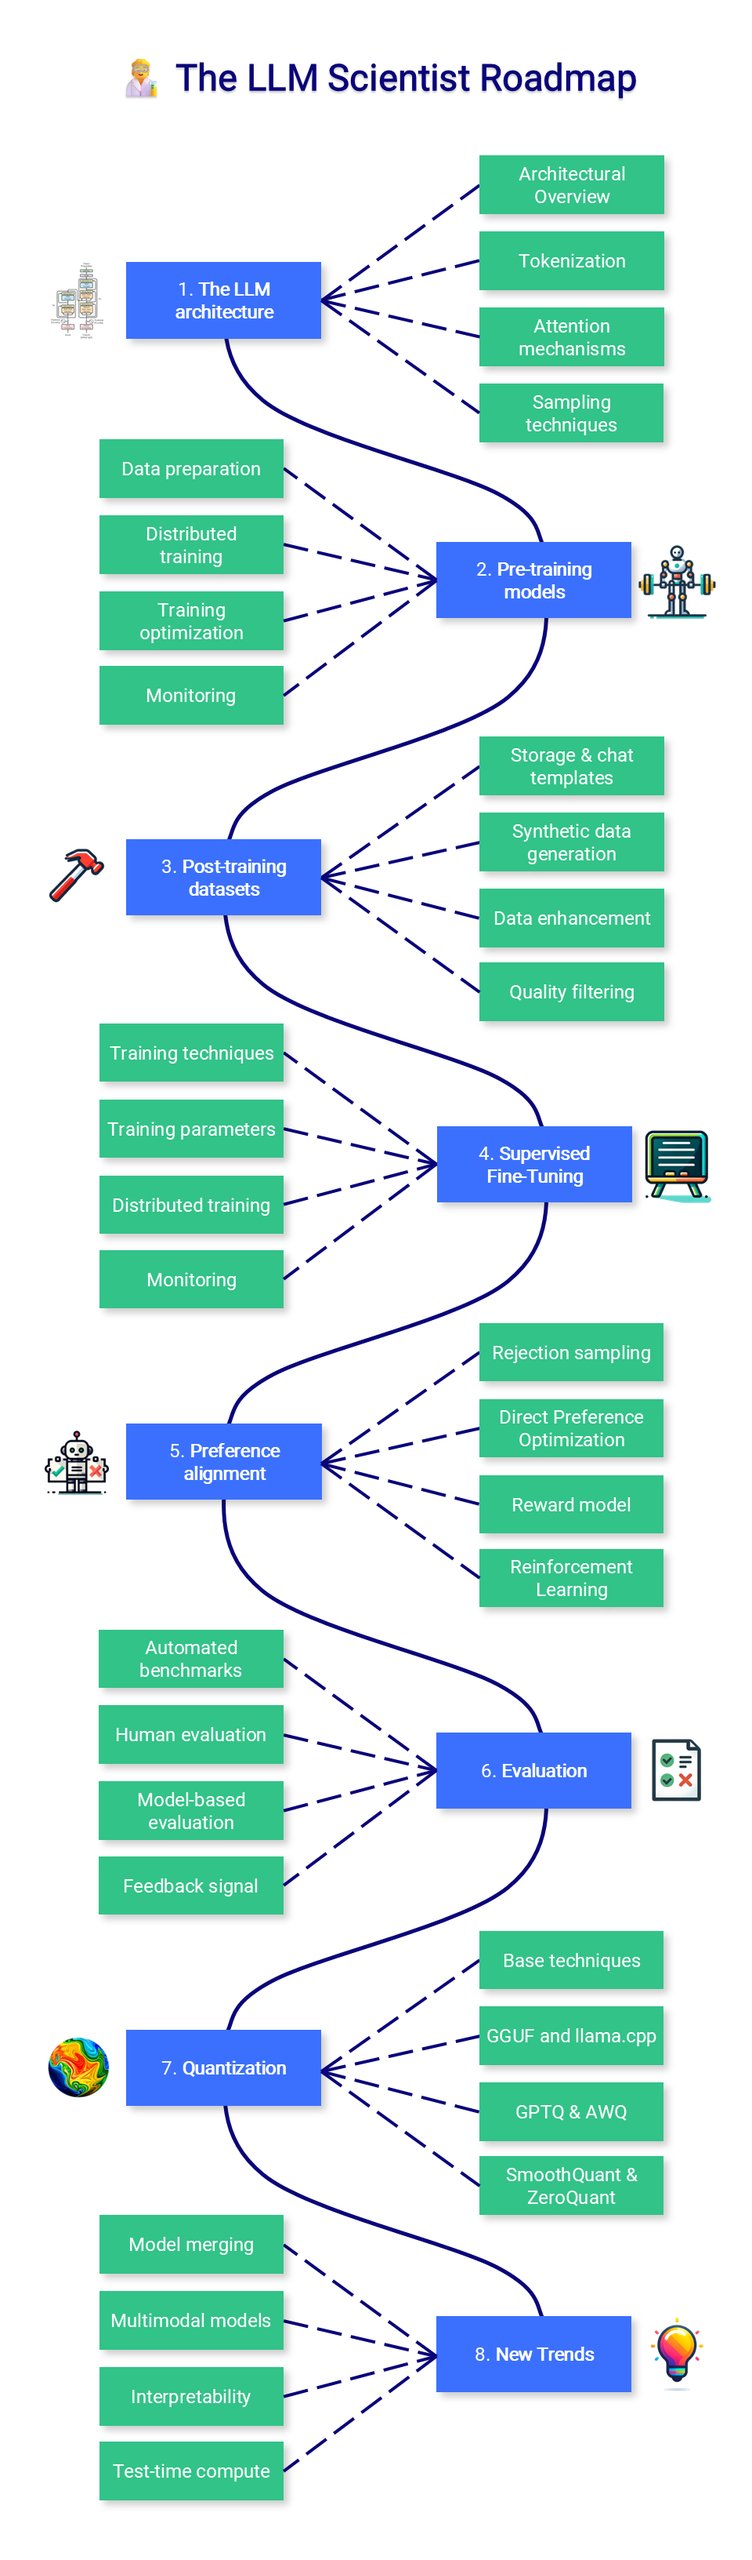
- 从零开始的三段式学习路径:基础数学和Python是选修,真正动手从“科学家”和“工程师”两条线并进,一条教你亲手搭出更强的模型,另一条教你把它变成能上线的聊天应用。
- 所有笔记本都托管在Google Colab上,点开即用。你不需要本地有显卡,也不用下载几十GB模型文件;每个Notebook开头都写着“Free tier compatible”,明确告诉你能在免费账号里跑通。
- 提供7个开箱即用的工具型Notebook,比如LazyMergekit一键合并模型、AutoQuant自动转成GGUF/GPTQ格式、ZeroSpace用免费ZeroGPU生成Gradio界面,每一步都有按钮、有注释、有结果预览。
- 细到手把手教你用QLoRA在免费Colab上微调Mistral-7b,连显存不够时该关掉哪些后台进程都写了提示;也包含ORPO单阶段微调Llama 3的完整流程,比传统SFT快且便宜。
- 附带模型家族树可视化工具,输入两个模型名,自动生成它们的血缘关系图,不是抽象概念,是真实可点开看的网页图谱。
- 所有内容持续更新:作者在README里明确说“这门课将永远免费”,而配套出版的《LLM Engineer’s Handbook》是付费书,但课程本身不设任何门槛或隐藏章节。
上手只要三步
- 打开GitHub主页:https://github.com/mlabonne/llm-course,下拉到“Notebooks”章节,找到你想试的那一个(比如“Fine-tune Llama 3.1 with Unsloth”);
- 点击右侧那个蓝色的“Open in Colab”按钮,它会自动跳转到Google Colab界面,无需登录也能预览;
- 点击左上角“运行全部”,等进度条走完,你就在云端跑通了第一个大模型微调任务,整个过程不需要在自己电脑上装任何东西。
项目信息

mlabonne/llm-course
GitHub
Course to get into Large Language Models (LLMs) with roadmaps and Colab notebooks.
84.9k
Stars
9.9k
Forks
Unknown
Apache-2.0