你是不是也这样:想给老电影加中文字幕,结果发现字幕是“焊”在画面上的——没法导出,只能暂停、截图、OCR、对时间轴、导出srt……一集40分钟的剧,光扒字幕就得两小时。
市面上能干这活的工具,要么要注册账号、等API配额,要么按月收钱,还动不动就识别错字、漏行、把台标当字幕。
其实不用这么折腾。有个本地跑的免费工具,不联网、不传视频、不绑手机,装上就能用。
它不依赖云端服务器,所有识别都在你自己的电脑里完成。连截图都不用另存,程序内部直接读取视频帧数据。
你选好一个MP4或MKV文件,拖动鼠标框定字幕常出现的位置,点运行——十几秒到几分钟后,同目录下就多了一个标准srt文件。
时间轴自动对齐,换行逻辑合理,中英混排不串行,连日语假名和阿拉伯数字都能分清。
能替代什么 / 能省多少钱
它取代的不是某一款具体软件,而是你为「硬字幕转外挂字幕」付过的所有钱和时间:比如某款收费OCR桌面版(年费398元)、某在线字幕提取服务(单视频15元起)、还有你反复试错花掉的两三个晚上。
字幕全程在你电脑里识别,连截图都不用存。
官方没提定价,但功能对标的是付费OCR+字幕对齐+批量处理三合一服务。按保守估算,一年省下至少400元,还不算你省下的时间成本。
价格直接砍到零。
它也不需要你学命令行。没有“conda install”、没有“pip install -e .”,更不用查显卡型号配CUDA版本,这些都留给源码用户。
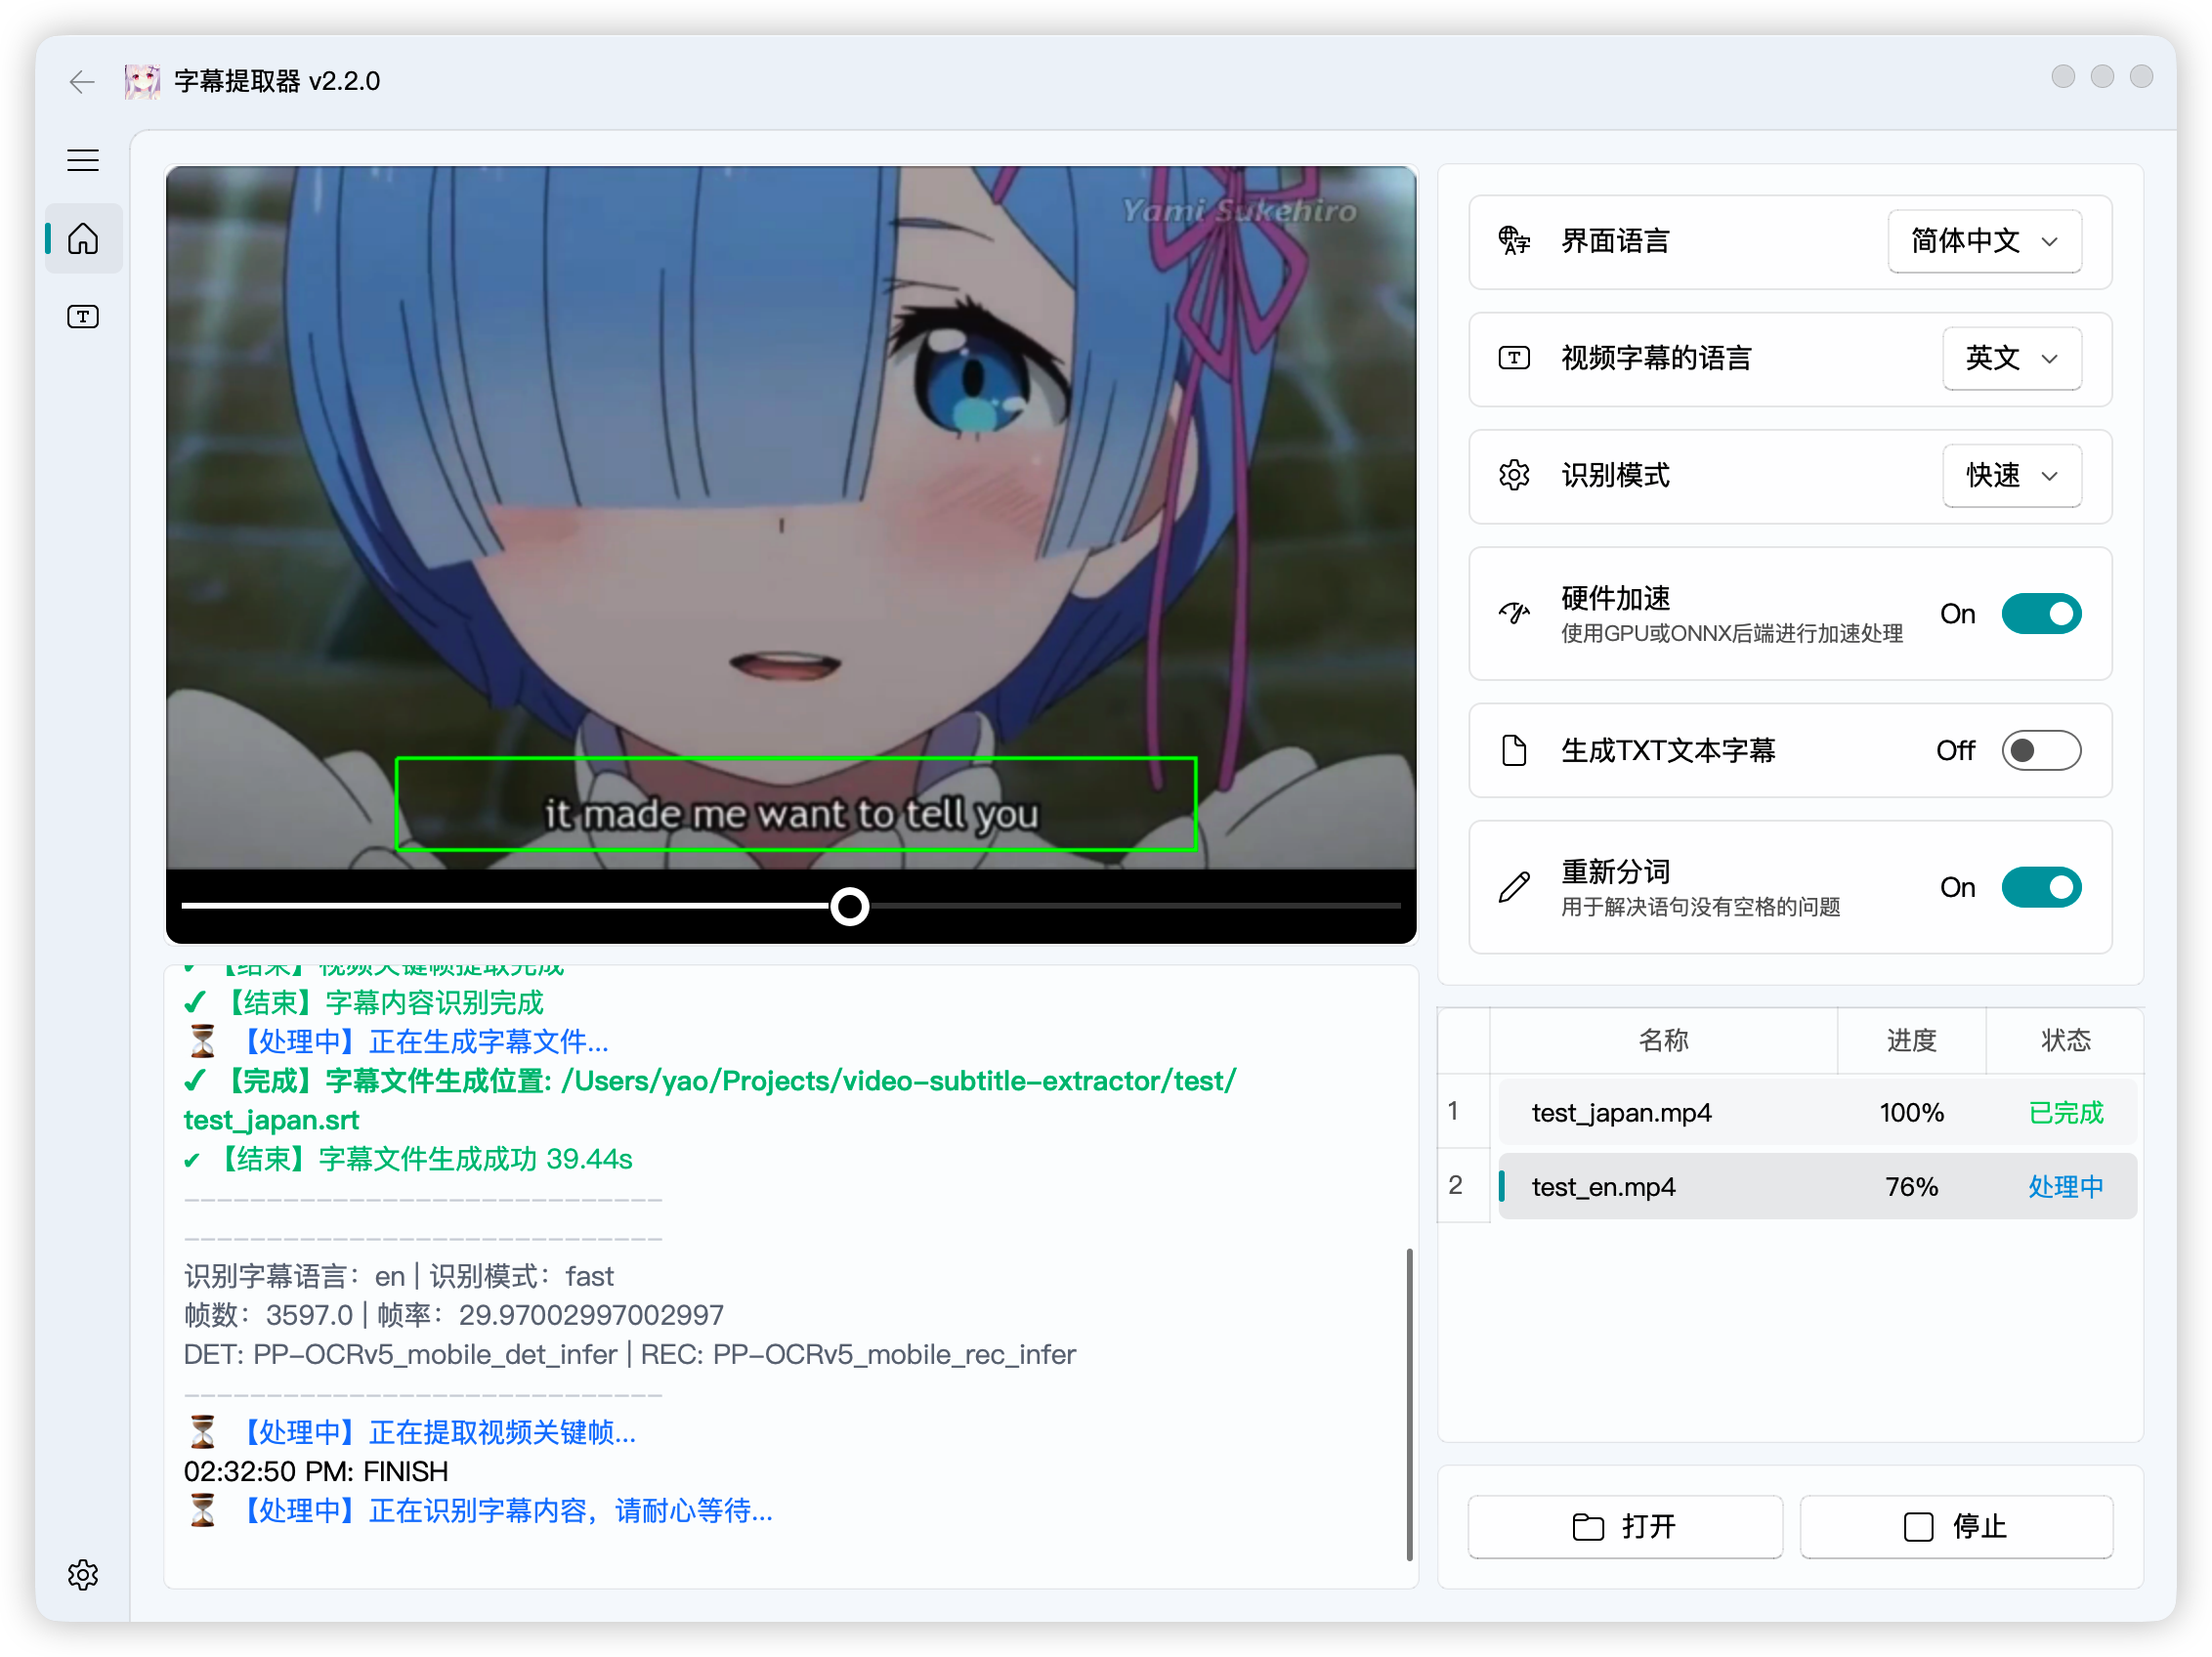
普通用户下载解压后,双击就能打开图形界面。菜单栏只有四个按钮:【打开】【运行】【设置】【帮助】,每个功能都直白对应一件事。
它能干什么

- 从视频画面里自动框出字幕区域,不用你一帧一帧调,哪怕字幕位置不固定、偶尔跳动,也能跟住;程序默认检测视频前30秒的关键帧,自动聚类出最常出现文字的矩形区域,你只需微调蓝色边框的上下左右边界即可;
- 把框出来的字幕内容准确识别成文字,支持简体中文、英文、日语等87种语言,中英双语混排也能分清;识别时会保留原始换行,比如字幕分两行显示,输出srt里就是两行,不会强行合并成一句;
- 自动过滤水印、台标、角标、弹幕残留,还能自定义删掉“性感荷官在线发牌”这种乱码;编辑
backend/configs/typoMap.json后,下次运行自动生效,替换规则支持正则表达式语法; - 合并重复出现的字幕行,智能判断哪几帧属于同一句,再按标准srt格式生成带时间轴的文件;例如连续12帧显示同一句字幕,程序只保留起始和结束时间戳,不生成12条重复条目;
- 一次选多个视频,只要分辨率和字幕位置一致,就能批量跑完,10个视频,点一次运行就行;程序会逐个处理,每个视频生成独立srt,文件名自动追加
_sub后缀; - 有GPU就用GPU加速,没GPU也能跑,只是慢一点;Windows/macOS/Linux全支持,界面是中文的,点哪看哪;GUI顶部状态栏实时显示当前帧数、OCR模型加载进度、剩余预估时间。
三步上手
- 去GitHub的Release页面下载最新版压缩包,解压后双击
video-subtitle-extractor.exe(Windows)或对应可执行文件;Mac用户注意选择.dmg包,Linux用户选.AppImage; - 点击【打开】按钮,选一个视频(单个或多个),程序会自动预览关键帧,你只需拖动蓝色框线,把字幕区域圈准;如果字幕在画面底部居中,通常框高约80像素、宽占画面90%,位置偏右时可单独调整右边界;
- 选好模式(推荐“快速”或“自动”),点【运行】,等进度条走完,srt文件就生成在原视频同目录下了,整个过程不需要输命令、不装Python、不配环境;生成失败时,界面底部会提示具体原因,比如“路径含中文”或“ffmpeg未找到”。