你有没有过这种时候:凌晨两点对着一篇PDF发呆,谷歌翻译翻得前言不搭后语,DeepL又不支持LaTeX公式?
你有没有过这种时候:导师催着改稿,你把中文初稿丢进某付费润色平台,等半小时出结果,发现连“显著性”都译成了“明显性”?
你有没有过这种时候:想试试本地模型,却卡在CUDA版本、量化格式、模型路径三连问里,最后默默关掉命令行?
替代了哪些付费软件

它不直接对标某一个名字响亮的SaaS工具,而是把好几类「按页/按次收费」的学术服务,一次性打包免费化了。
不是买不起,是根本不用买了。
比如PDF论文精细翻译——Doc2x插件调用的是原生接口,效果接近收费版DeepL Pro+LaTeX解析器组合,但全程不联网上传原文;比如GLM4/Qwen2.5-max等中文大模型接入,省下文心一言会员(199元/年)和通义千问Pro API调用费(按token计费);比如代码解释与C++项目剖析功能,相当于白嫖了一个带上下文理解的私有Copilot。
价格直接砍到零。
它能干什么

- 一键翻译整篇arXiv论文,保留公式、图表编号、参考文献层级,还能导出为Markdown或Word——这是目前唯一公开可部署的高质量学术PDF翻译方案,连LaTeX源码里的\cite{}和\ref{}都能对应上。操作路径是:点击左侧「学术增强」→「Arxiv论文翻译」→ 粘贴arXiv ID(如2305.12345),或拖入本地PDF,自动识别并分节处理。
- 把一段乱糟糟的Python脚本拖进去,点“代码解释”,它会逐行说明逻辑,再点“函数重构”,自动生成带类型提示、docstring和错误处理的版本,比你在ChatGPT里反复追问快3倍。支持.py、.ipynb、.cpp、.java等多种后缀,对PyTorch DataLoader和SQLAlchemy ORM结构也能识别上下文。
- 输入区打“API_KEY=qwen-key1,glm-key2”,回车,立刻切换模型;再打“API_KEY=”,清空,就退回默认配置。不需要重启程序,也不用改config文件。这个临时密钥只在当前会话生效,关闭浏览器标签即失效,安全可控。
- 装上SoVits语音克隆插件后,能用自己声音朗读GPT生成的摘要,不是TTS合成音,是你的声线,适合做汇报录音或课程配音。训练只需3分钟语音样本(建议朗读《学术英语常用句型》PDF附录),模型保存在本地./sovits_models/目录下。
- 写论文时右键选中一段英文,快捷键Ctrl+Shift+R,自动润色成符合Nature投稿风格的句子,语法纠错+术语统一+被动转主动,3秒完成。它还会高亮修改处,鼠标悬停显示修改依据,比如“‘utilize’ → ‘use’:Nature指南第4.2条建议避免冗余动词”。
- 虚空终端插件启动后,你直接说“把刚才那篇论文总结成三句话,发到微信文件传输助手”,它就调用其他插件自动执行,不用记命令,像跟人说话一样调度工具链。背后实际触发了:PDF解析→摘要生成→文本转语音→调用微信API(需提前配置wechat_config.json)。
三步上手
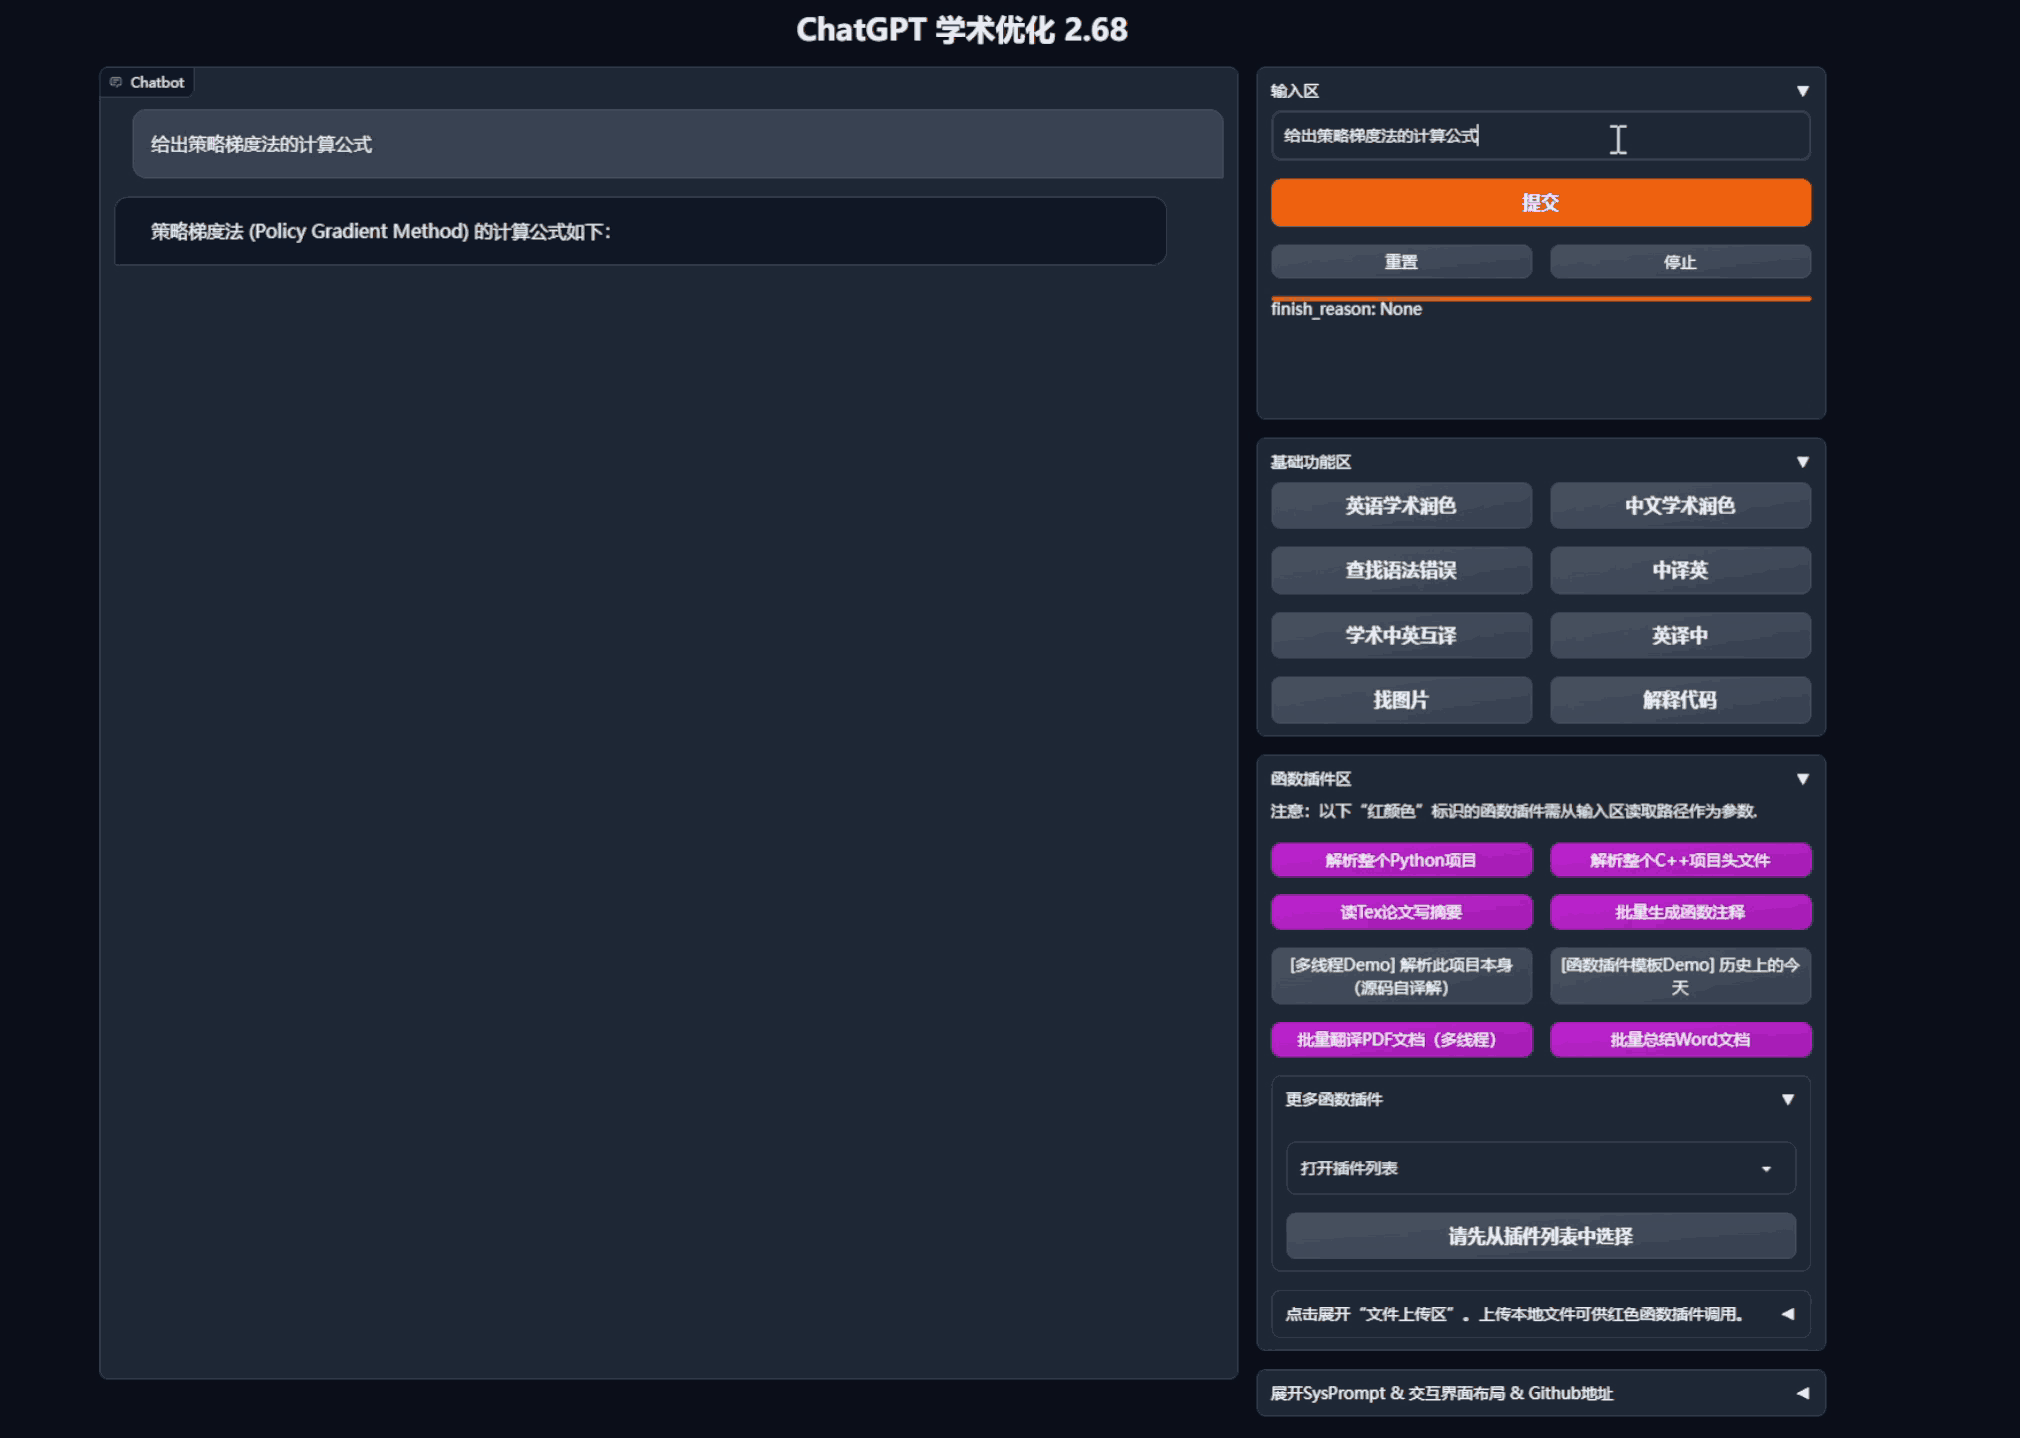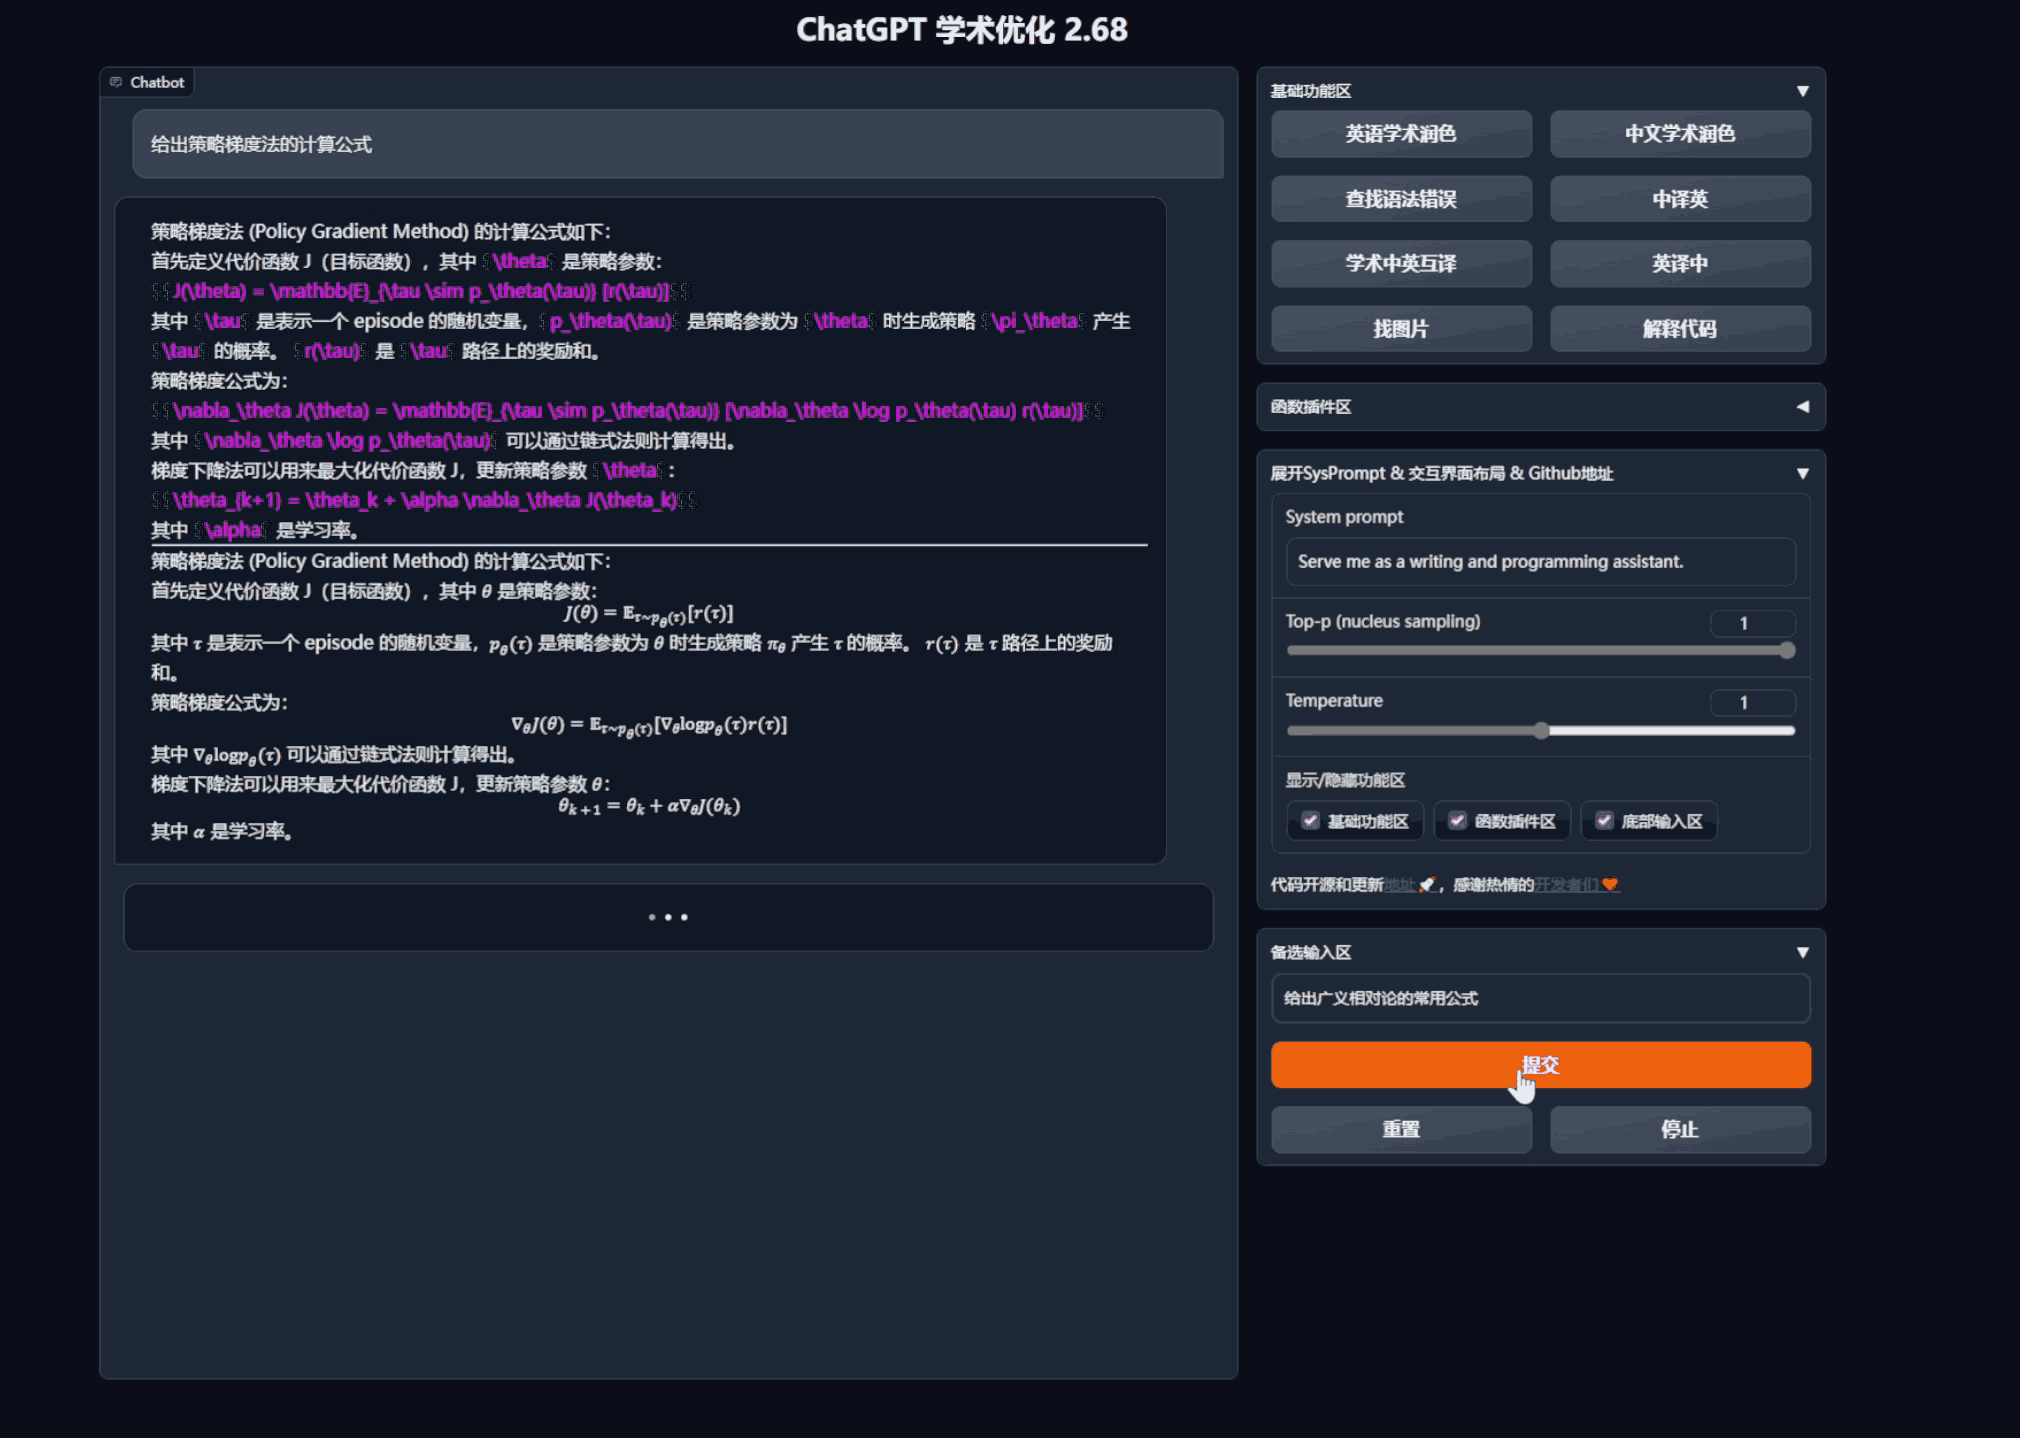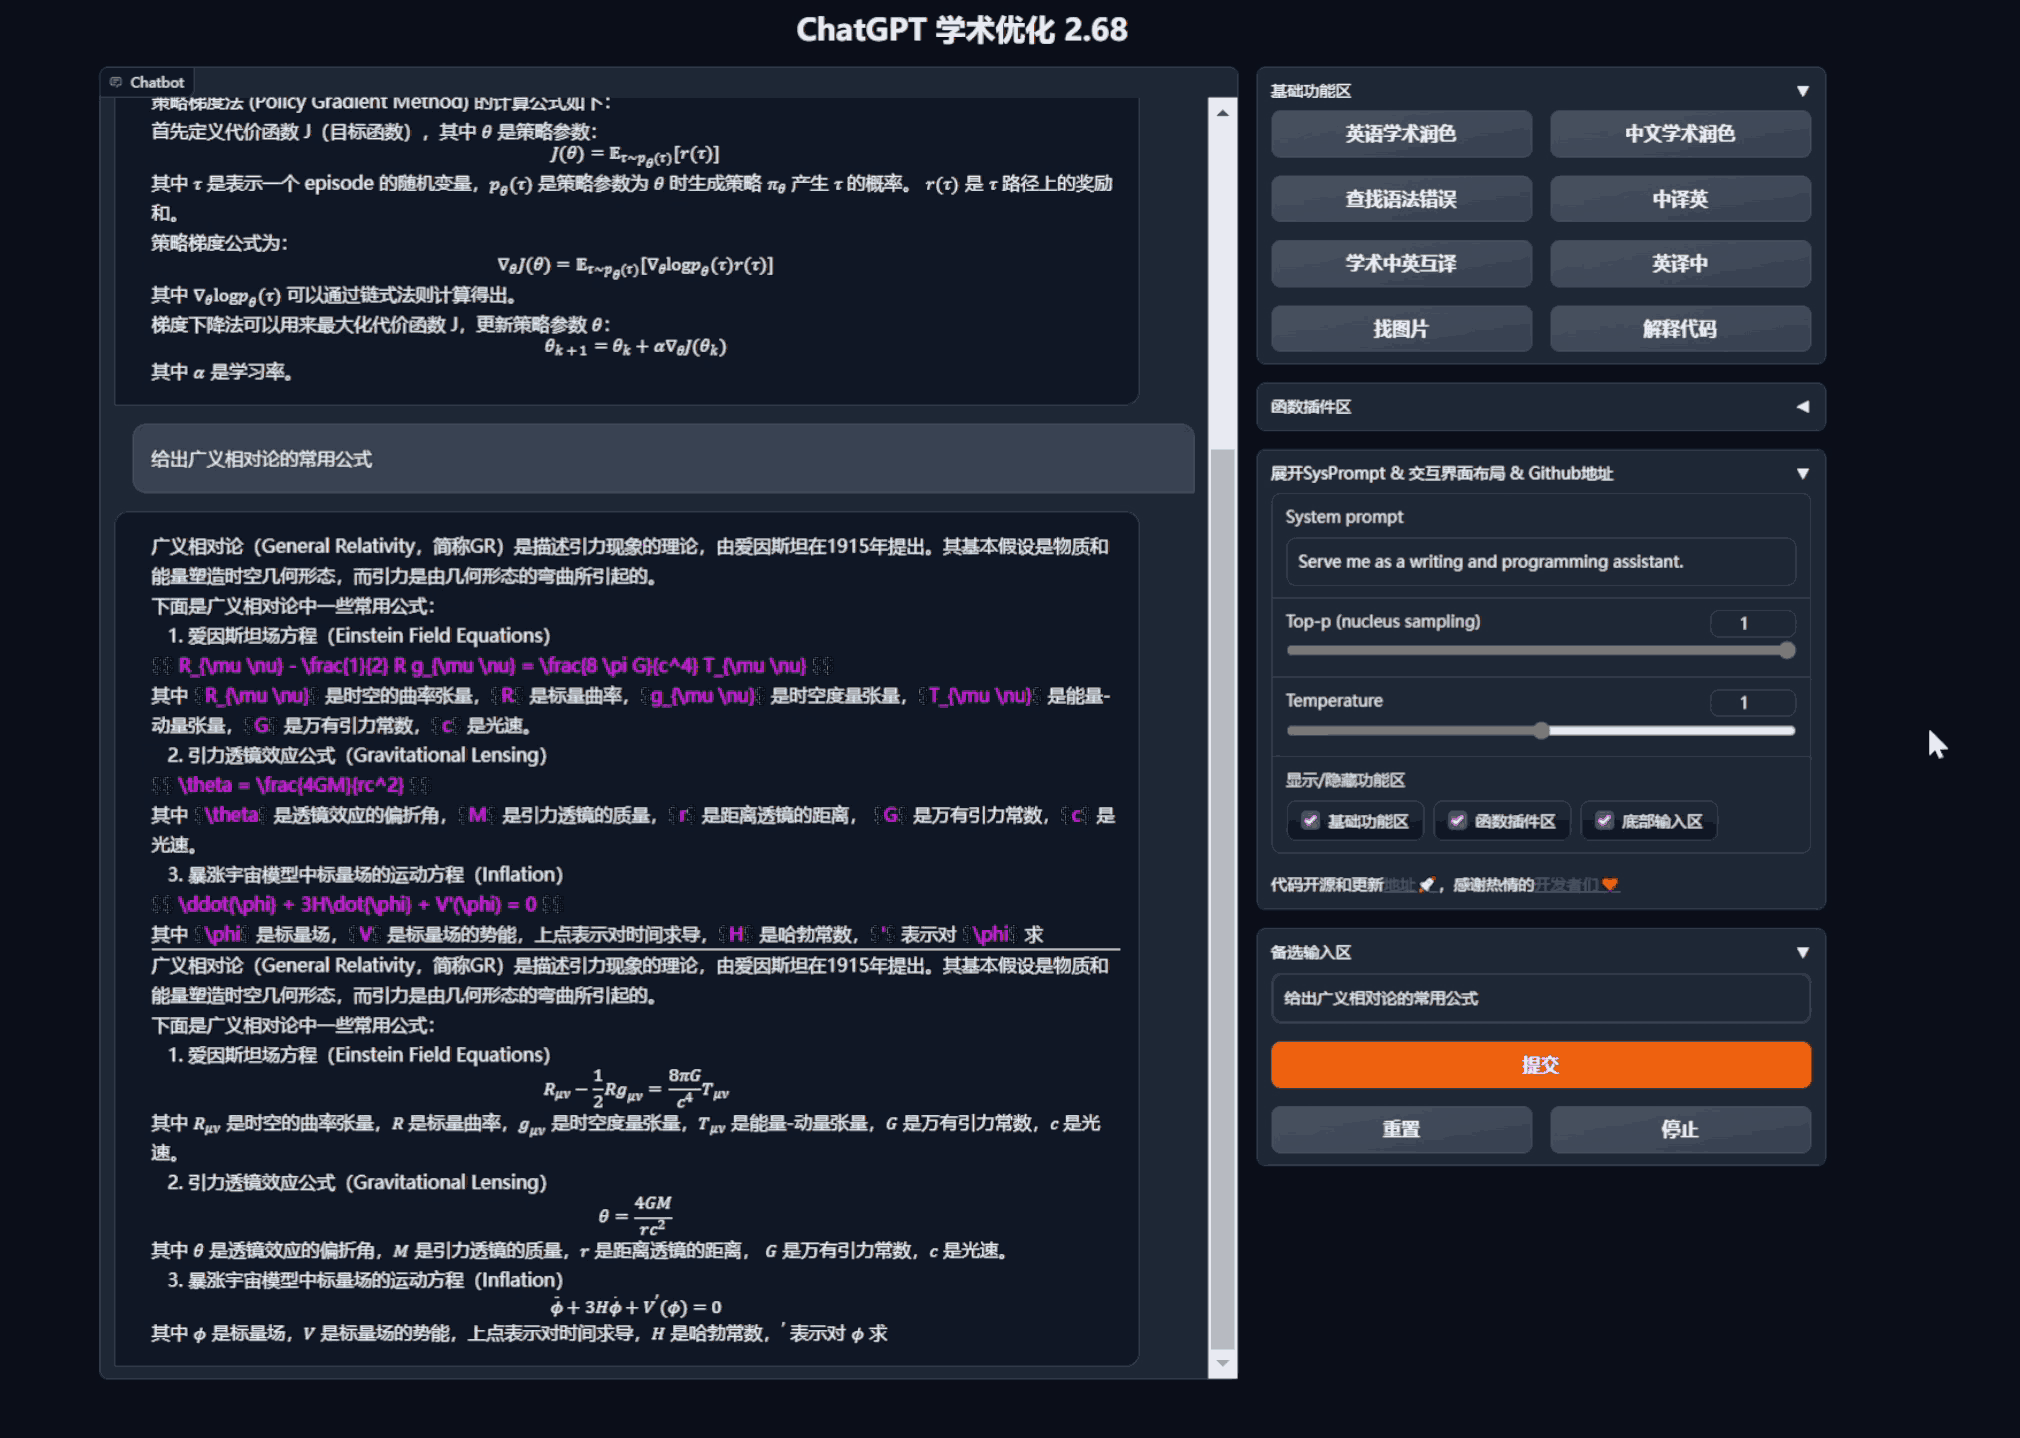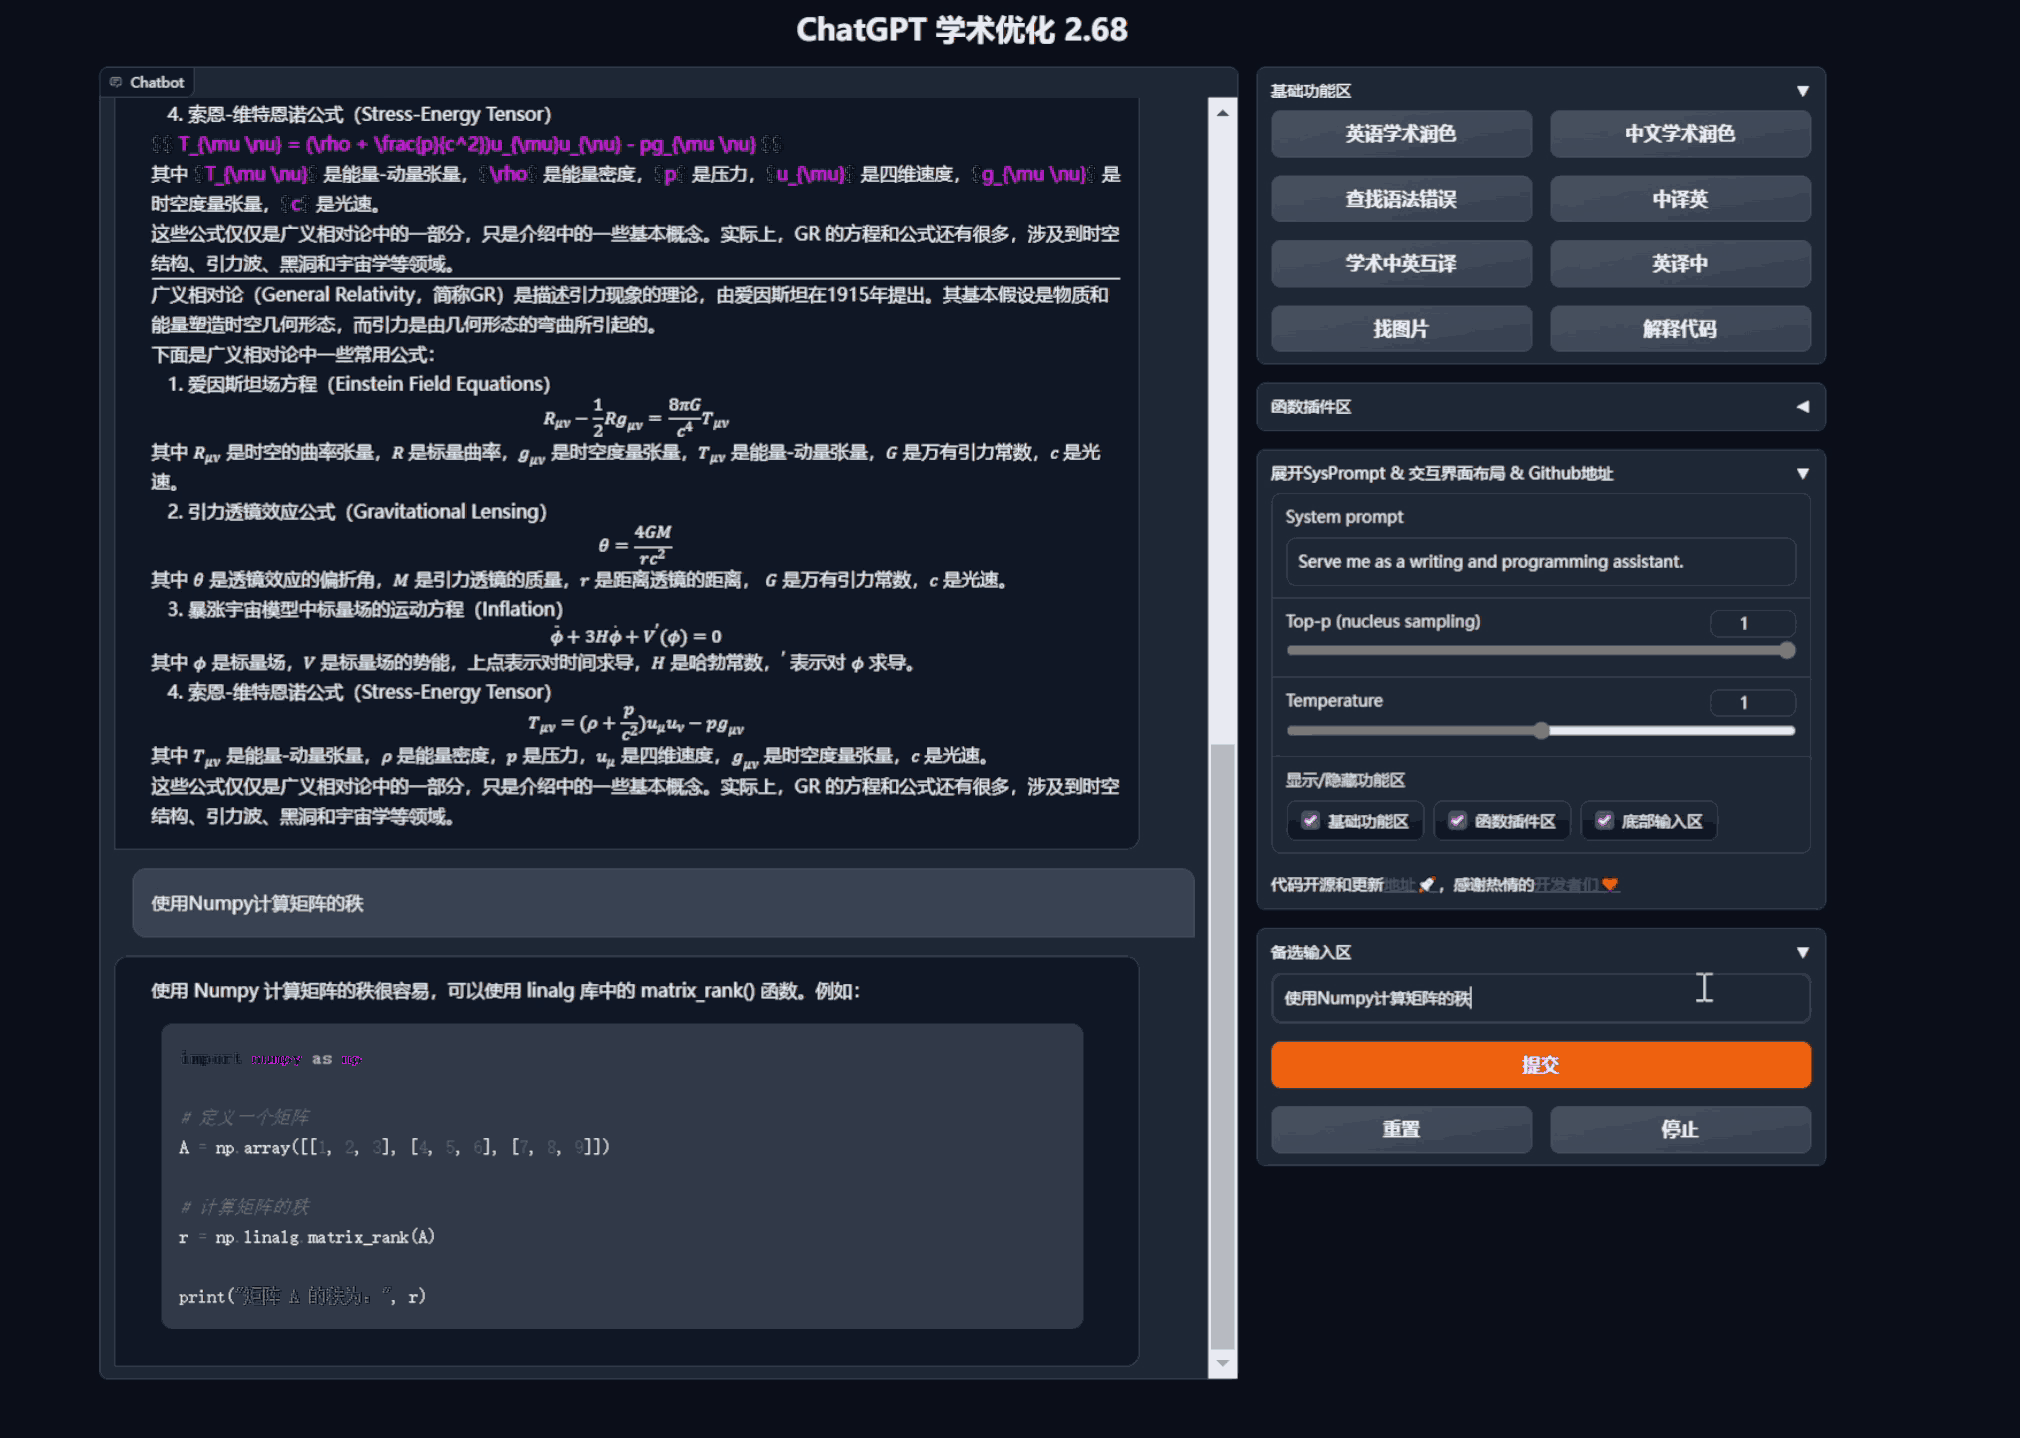
- 去GitHub Releases页面下载最新版zip包(Windows用户选gpt_academic_windows_x64.zip,Mac选darwin-arm64.zip),解压后双击start.bat(Win)或start.sh(Mac/Linux)即可启动。Mac M系列芯片用户若遇到权限提示,右键→“显示简介”→勾选“允许从任何来源运行”。
- 首次运行会自动安装依赖,约1-2分钟;完成后浏览器打开http://127.0.0.1:7860,界面就是中文,无需额外设置语言。如果端口被占用,可在config.json中修改port字段,例如改为”port”: 7861。
- 在右上角“配置”里填入你已有的任意一个大模型API密钥(如通义千问、GLM、讯飞星火),保存后就能开始使用,没密钥也能用本地模型,但需要额外下载,文档里写了具体路径。比如Qwen2.5-7B-Chat模型,需从ModelScope下载后放入./models/qwen/目录,并在config.json中指定model_path。
项目信息
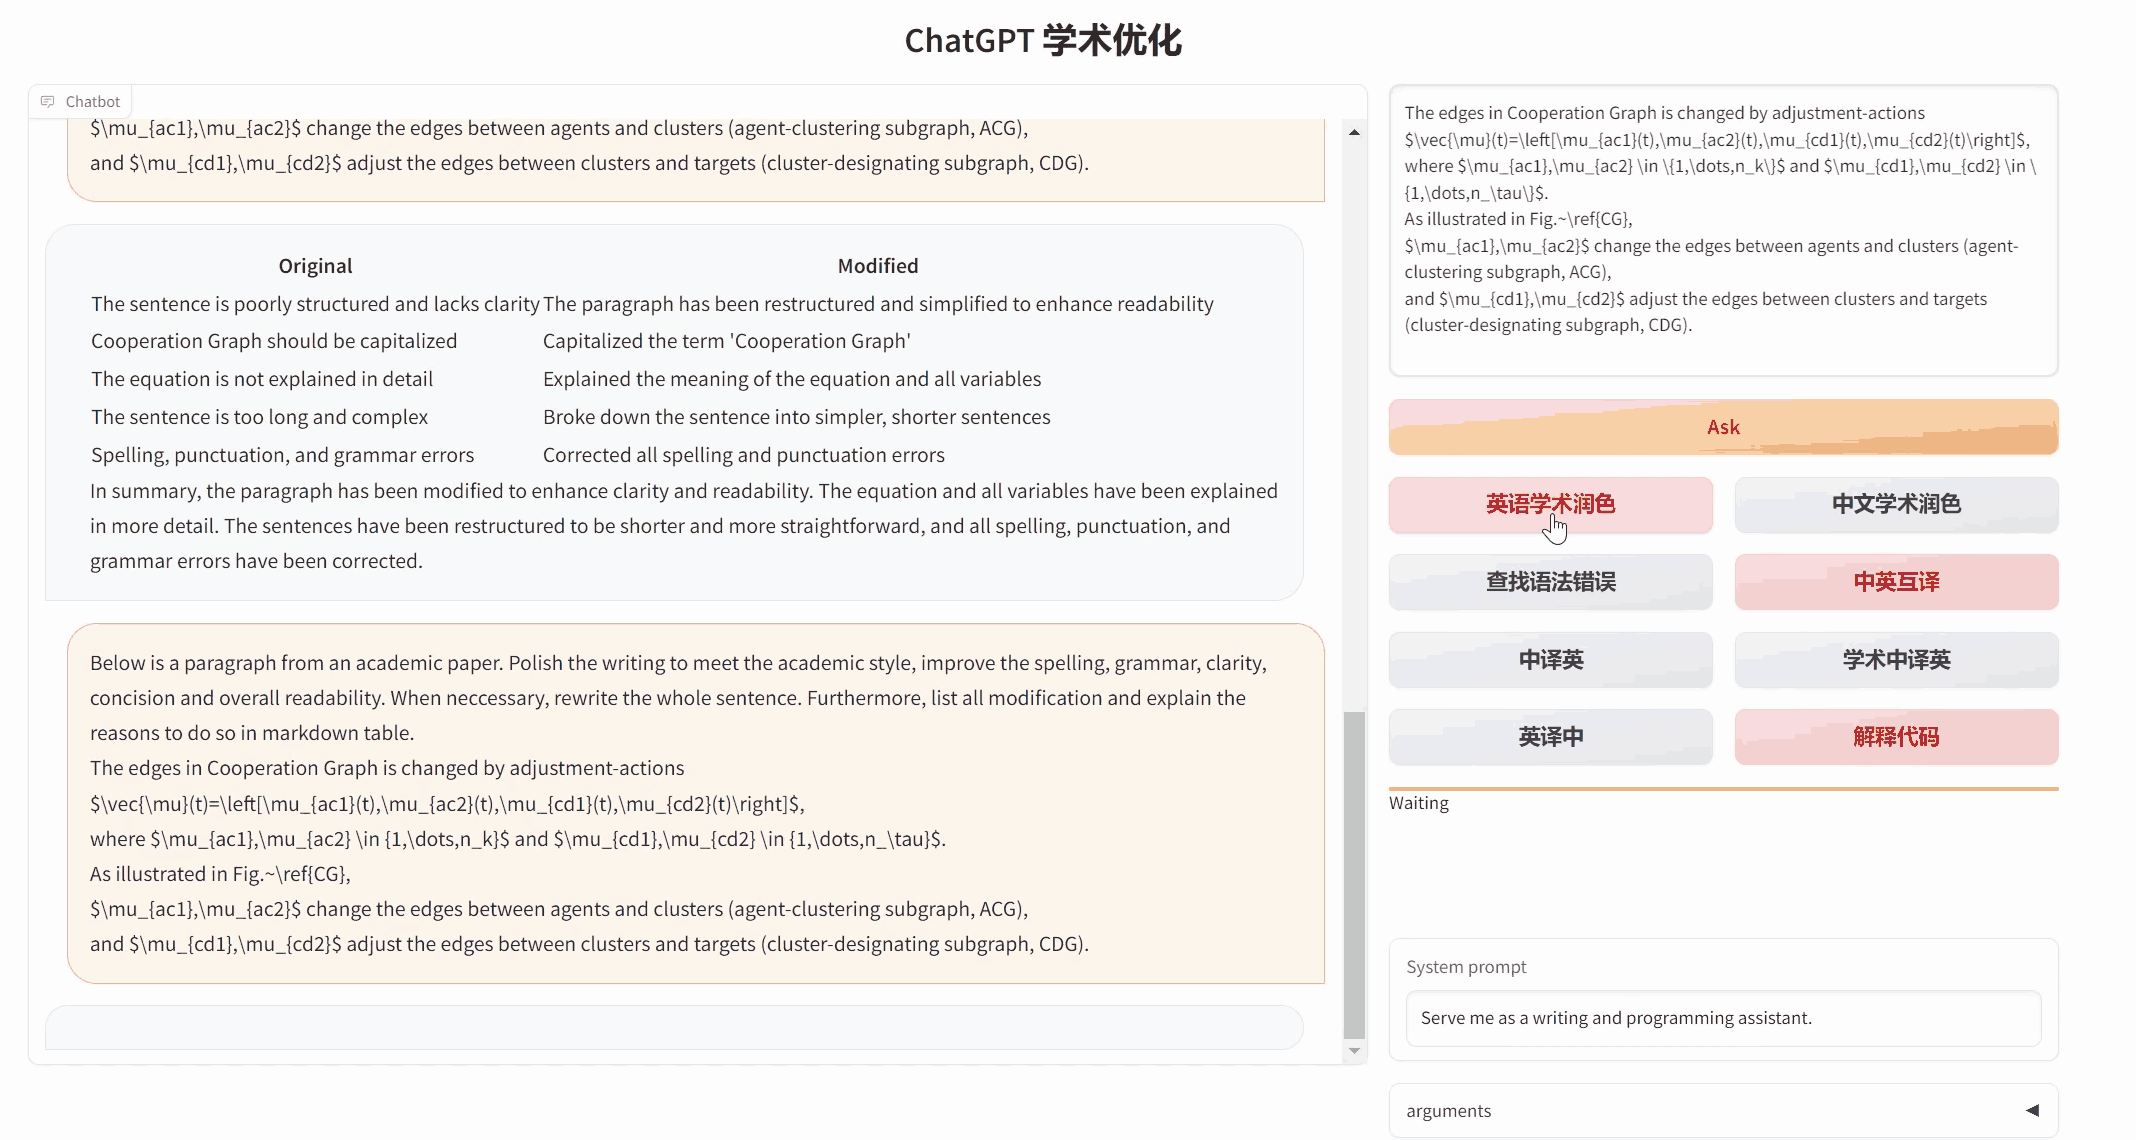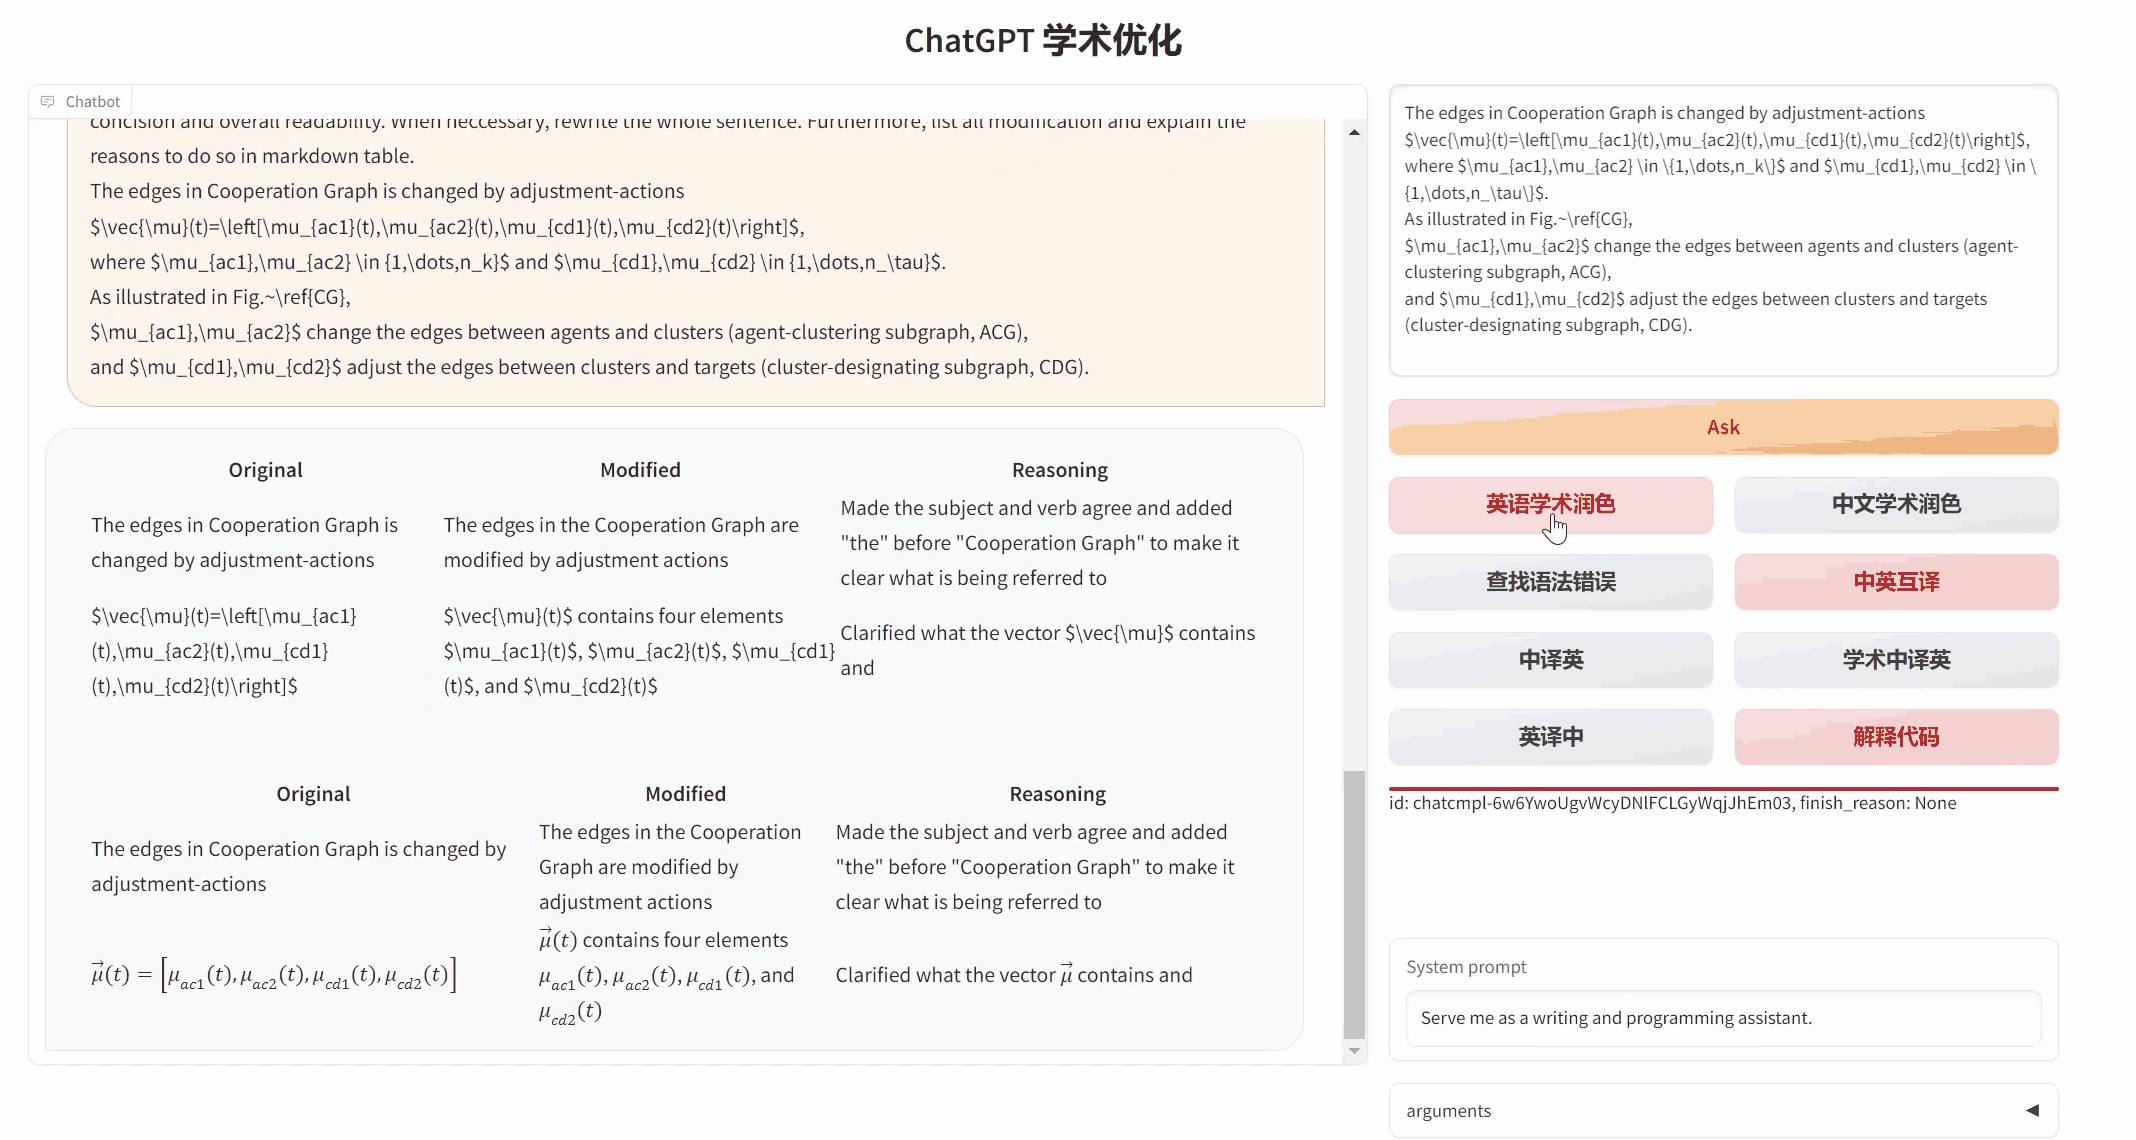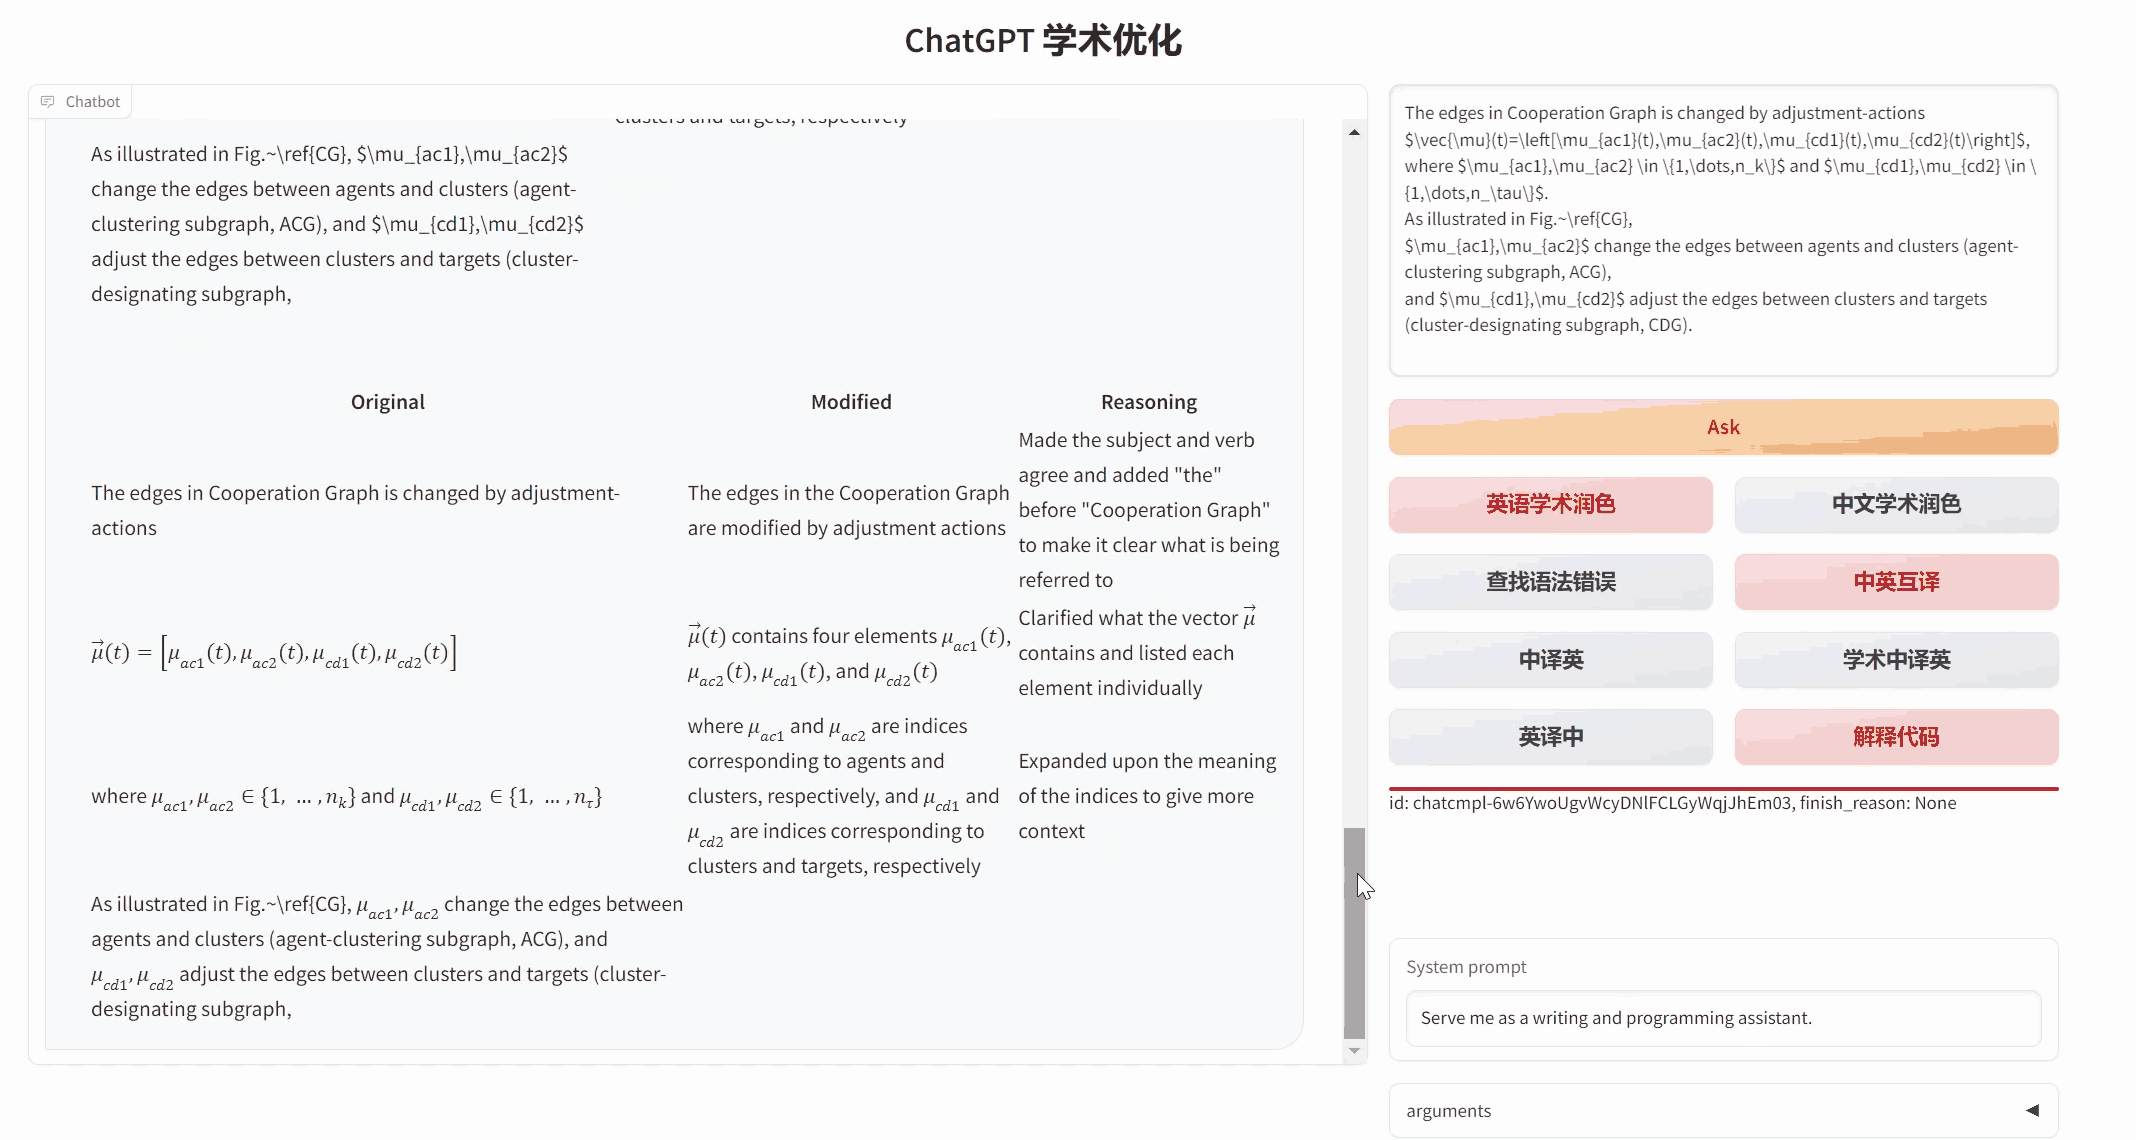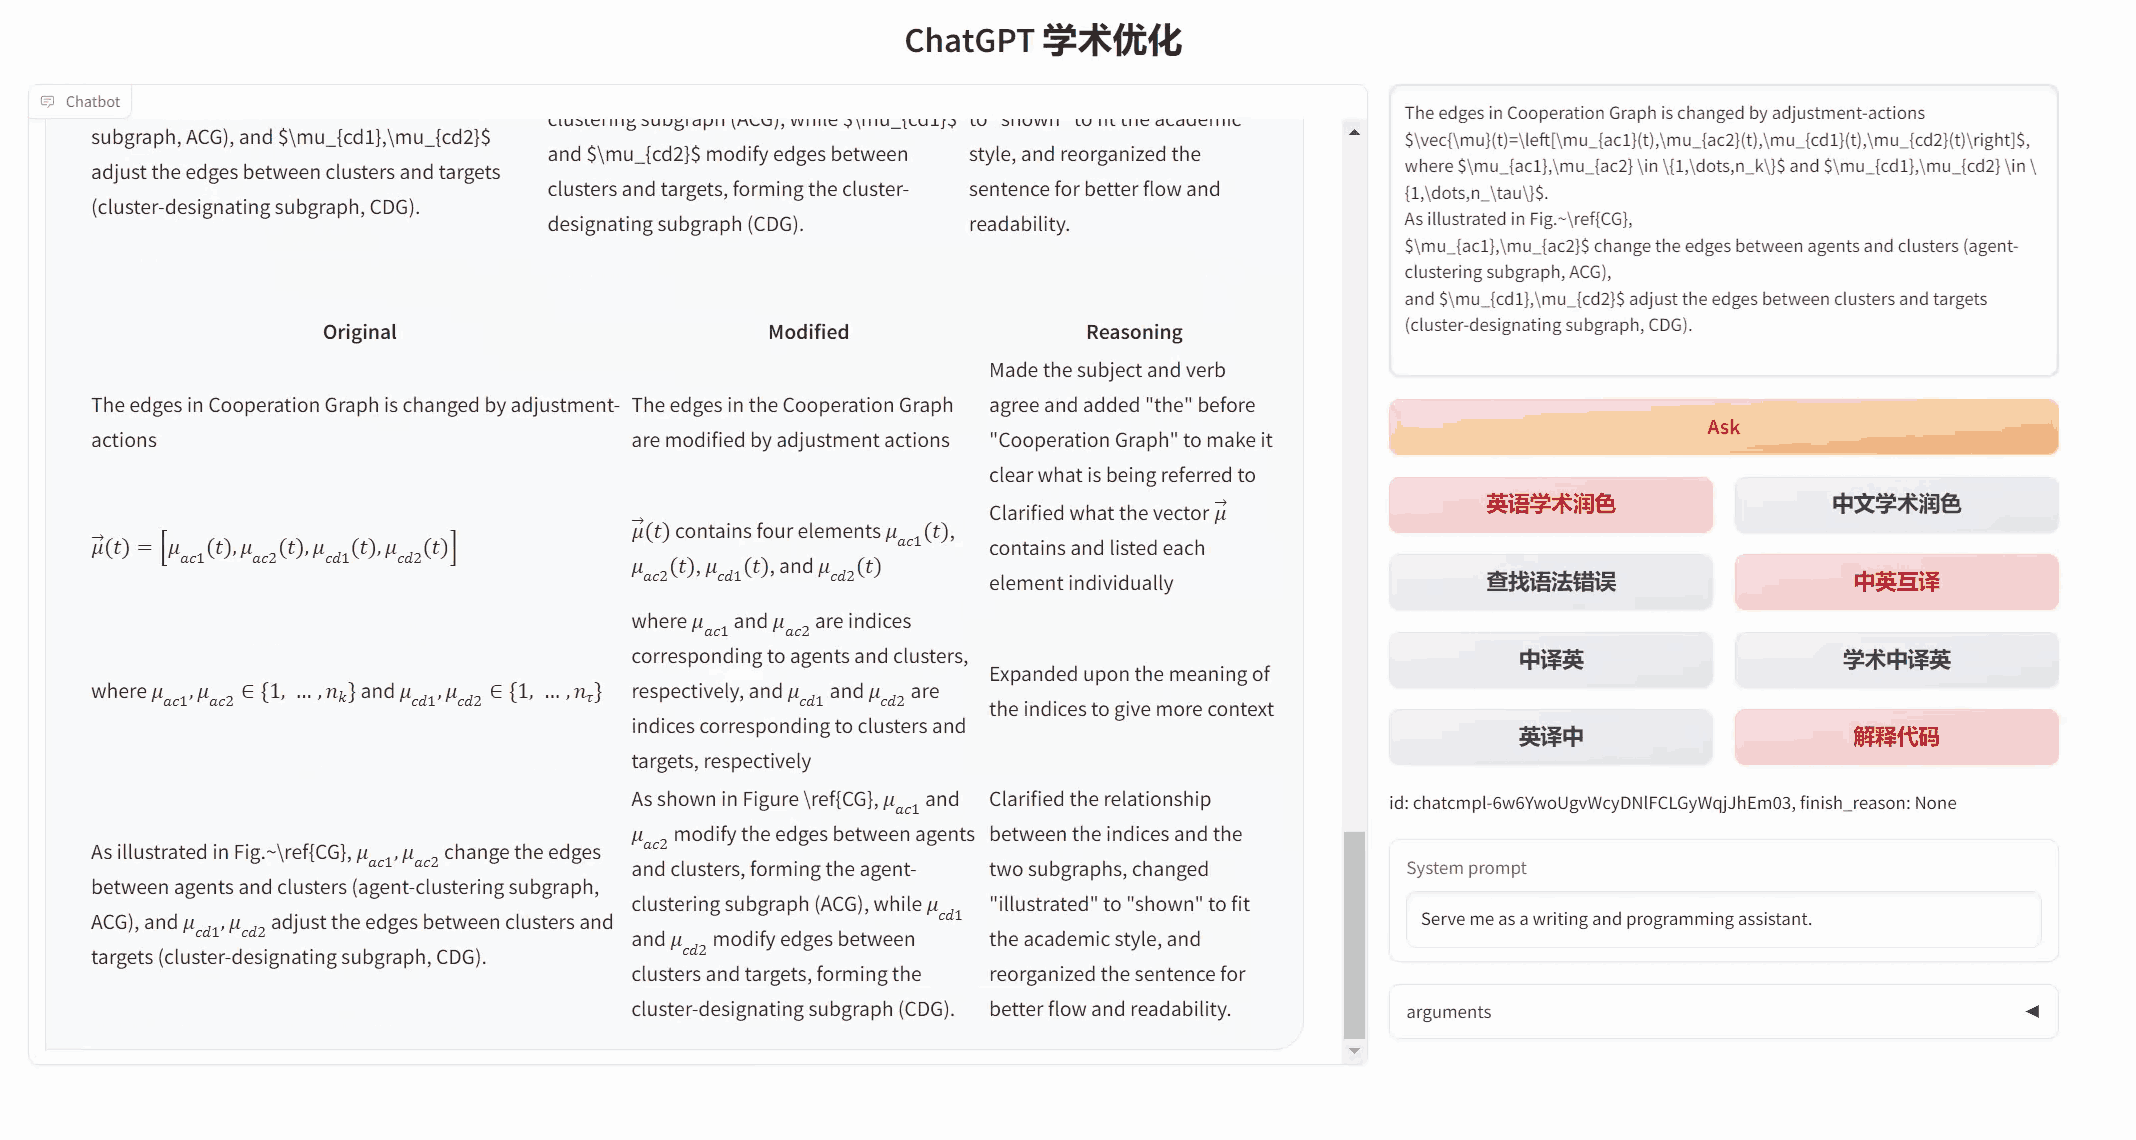
为GPT/GLM等LLM大语言模型提供实用化交互接口,特别优化论文阅读/润色/写作体验,模块化设计,支持自定义快捷按钮&函数插件,支持Python和C++等项目剖析&自译解功能,PDF/LaTex论文翻译&总结功能,支持并行问询多种LLM模型,支持chatglm3等本地模型。接入通义千问, deep
⭐
71.6k
71.6k
Stars
🔀
8.3k
Forks
8.3k
Forks
Python
📄
GPL-3.0
GPL-3.0