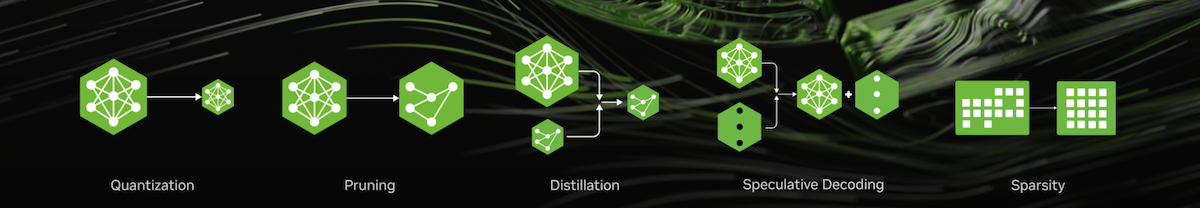
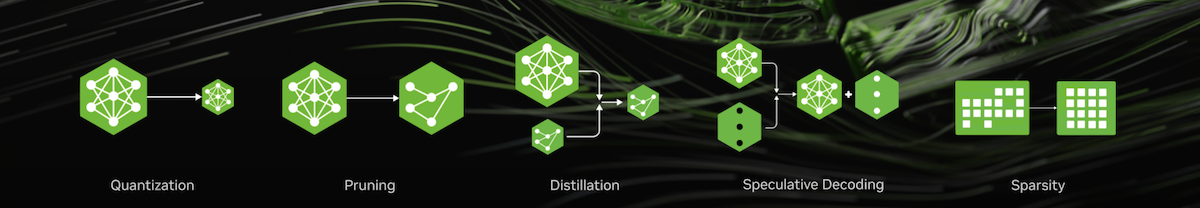
你是否遇到过这样的困境:训练好的 35B 大模型,在 vLLM 上推理延迟高、显存占用爆表,部署成本居高不下?或者好不容易量化到 FP8,精度却断崖式下跌,业务指标直接翻车?NVIDIA Model Optimizer(简称 ModelOpt)正是为解决这一系列“模型又大又慢又不准”的落地顽疾而生——它不是单一量化工具,而是一套覆盖量化、剪枝、蒸馏、NAS、推测解码等全链路的工业级模型压缩操作系统,专为将 Hugging Face/PyTorch/ONNX 模型高效交付至 TensorRT-LLM、vLLM、SGLang 等主流推理引擎而深度优化。
核心功能
- 端到端 NVFP4/W4A4 量化+蒸馏闭环:解决“极致压缩必掉点”的行业痛点。例如 Qwen3.6-35B-A3B 案例中,通过 PTQ(Post-Training Quantization)+ QAD(Quantization-Aware Distillation),在 W4A4 + NVFP4 极限压缩下,模型体积缩小 3.1 倍,vLLM 吞吐提升 1.30×,同时完整恢复 BF16 级别精度,真正实现“小而准”。
- 异构化混合剪枝与 NAS 联合搜索(Puzzletron):突破传统“先剪枝后微调”的线性流程。Puzzletron 算法可对 LLM/VLM 模型同步执行结构化剪枝(如 Minitron)与子网络架构搜索,在 Bielik.AI 实践中,7B 模型经 Minitron 剪枝+蒸馏后体积缩小 33%,推理速度提升 50%,关键任务质量保留率达 90%。
- 本地 Hessian 权重缩放(Local-Hessian Weight Scales):精准解决 FP4/NVFP4 量化中权重分布不均导致的精度崩塌问题。该技术通过局部二阶信息动态校准每层缩放因子,在 Nemotron-3-Ultra-550B 的 NVFP4 量化中,使 decode-heavy 场景吞吐达 GLM-5.1 754B FP4 的 5.9×,同时严格匹配 BF16 准确率。
- 全自动混合精度分配(AutoQuantize):告别手动逐层调参。AutoQuantize 可基于模型敏感度分析,5 分钟内自动为 Transformer 各子模块(QKV、FFN、LayerNorm)推荐最优精度组合(如 W4A8 + W8A8 + FP16),显著降低量化门槛。
- 无缝对接 Megatron-Bridge 与 Hugging Face Accelerate:解决“训练-优化-部署”割裂难题。用户可直接在 Megatron-LM 或 HF Accelerate 训练流程中嵌入 ModelOpt API,原生支持量化感知训练(QAT)、两阶段蒸馏等需训练介入的高级优化,避免模型格式转换损耗。
- 统一 Hugging Face 导出接口:终结“导出即报错”魔咒。ModelOpt 输出的优化后模型,可通过标准
model.save_pretrained()直接保存为 HF 格式,兼容 transformers 和 diffusers 生态,开箱即用于 vLLM、SGLang、TensorRT-LLM 等下游推理框架,无需额外转换脚本。 - 生产级 speculative decoding 支持:不止于静态压缩。ModelOpt 提供可插拔的推测解码模块,配合主干模型生成草稿序列,实测在 Llama-3-70B 场景下,结合 vLLM 的 speculative decoding,端到端首 token 延迟降低 42%,吞吐提升 2.3×。
技术亮点
- 面向部署闭环的架构设计:不同于 PyTorch 的
torch.quantization或 ONNX Runtime 的量化工具,ModelOpt 从诞生起就锚定“部署可用性”。其输出 checkpoint 不仅含量化权重,更内置适配 TensorRT-LLM 的 KV Cache 优化元数据、vLLM 的 PagedAttention 兼容张量布局,以及 SGLang 的 speculative decoding 接口规范,真正实现“一次优化,多平台直跑”。 - NVFP4 原生深度支持:作为 NVIDIA 自研的新型 4-bit 浮点格式,NVFP4 在保持数值表达能力的同时大幅降低带宽压力。ModelOpt 是目前唯一提供完整 NVFP4 工业链路(PTQ/QAT/QAD/Local-Hessian)的开源库,并已成功落地 Nemotron-3-Ultra-550B、Nemotron-3-Super-120B 等超大规模模型,Hugging Face 官方仓库已开放全部 NVFP4 检查点下载。
- 训练-推理协同优化栈:ModelOpt 并非独立工具,而是深度集成于 NVIDIA AI 软件栈:上接 Megatron-Bridge(打通 Megatron-LM 训练)、中连 Hugging Face Accelerate(支持 HF 生态微调)、下通 TensorRT-LLM/vLLM(部署即用)。这种“训练可感知、推理可执行”的设计,使 distillation、pruning 等需训练介入的技术真正具备工程可行性。
适合哪些人用
ModelOpt 主要面向三类用户:AI 基础设施工程师(负责将自研大模型接入 vLLM/TensorRT-LLM)、大模型应用开发者(需在有限 GPU 资源上部署多路 Qwen/Nemotron 模型)、企业级模型优化团队(如 Domyn、Bielik.AI 等主权 AI 厂商)。
真实场景案例:
• 金融风控实时问答系统:某银行将 30B 参数的行业大模型经 ModelOpt 执行“Minitron 剪枝 + 两阶段蒸馏 + FP8 量化”,在 A10 显卡上实现单卡并发 16 路,首 token 延迟稳定 <800ms,内存占用从 42GB 降至 16GB;
• 边缘端多模态助手:医疗设备厂商使用 ModelOpt 对 ViT-LLaVA 模型进行 Puzzletron 异构剪枝,将视觉编码器与语言模型联合压缩,在 Jetson Orin 上达成 12FPS 推理速度,满足手术室实时辅助需求。
快速上手
安装仅需一行命令(需 CUDA 12.2+ & Python 3.10+):
pip install nvidia-modelopt
以 Qwen2-7B 为例,5 行代码完成 W4A4 量化并导出至 vLLM:
from modelopt import quantize
from transformers import AutoModelForCausalLM
model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2-7B")
quant_config = {"quant_cfg": "W4A4_ASYM", "enable_kv_cache": True}
quantized_model = quantize(model, quant_config)
quantized_model.save_pretrained("./qwen2-7b-w4a4")
随后即可在 vLLM 中直接加载:vllm serve ./qwen2-7b-w4a4 --tensor-parallel-size 2
同类对比 / 注意事项
- vs Hugging Face Optimum:Optimum 侧重 ONNX Runtime/Triton 部署,量化粒度较粗(主要支持 INT8);ModelOpt 则聚焦 NVIDIA 全栈加速,深度支持 NVFP4/W4A4 等前沿格式,并提供 Local-Hessian 等精度保障技术,更适合追求极致性能的场景。
- vs llama.cpp:llama.cpp 为 CPU/CUDA 通用推理引擎,量化方案(如 GGUF)缺乏训练协同能力;ModelOpt 输出的 checkpoint 专为 TensorRT-LLM/vLLM 设计,且支持 QAT/QAD 等需训练介入的高级优化,精度-速度平衡更优。
- 注意事项:① NVFP4 依赖 CUDA 12.4+ 与最新版 TensorRT-LLM(≥v0.12),旧版本需升级;② Minitron 剪枝需配合 Megatron-Bridge 使用,纯 HF 模型建议优先尝试 AutoQuantize;③ Speculative decoding 需主干模型与草稿模型均经 ModelOpt 优化,不可混用不同量化策略。
项目信息
A unified library of SOTA model optimization techniques like quantization, distillation, pruning, neural architecture search, speculative decoding, et
4.0k
今日 +22 stars today
Stars
627
Forks
Python
Apache-2.0
编程语言:Python|GitHub Star 数:4003|开源协议:Apache-2.0|GitHub 项目地址
如果你正在被大模型的体积、延迟和精度三角矛盾所困扰,ModelOpt 不是一把锤子,而是一整套精密的“模型外科手术刀”——它让 NVFP4 不再是精度牺牲的代名词,让剪枝与蒸馏真正融入训练流水线,让每一次量化都成为可验证、可复现、可部署的确定性工程。