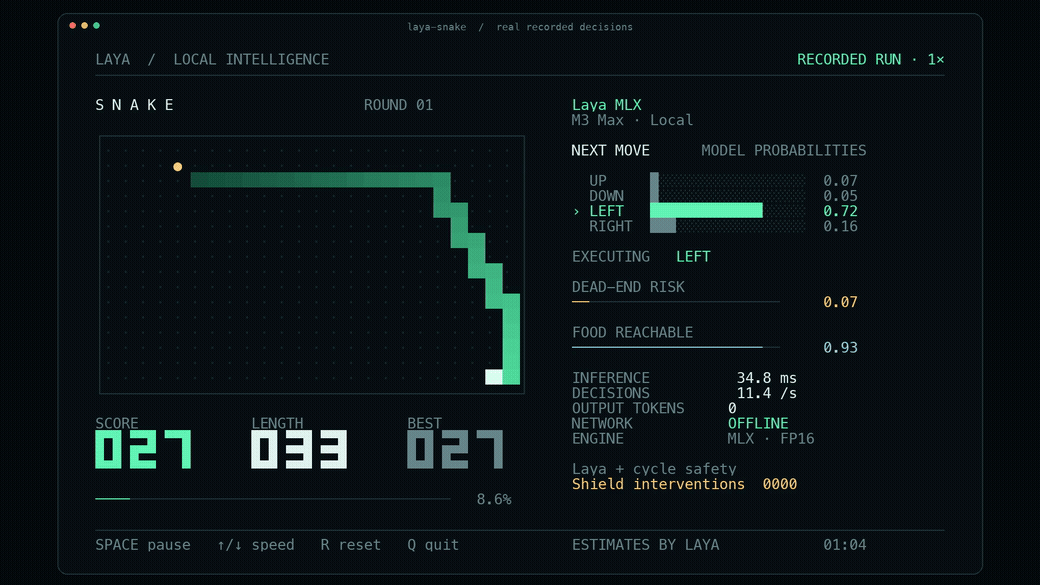
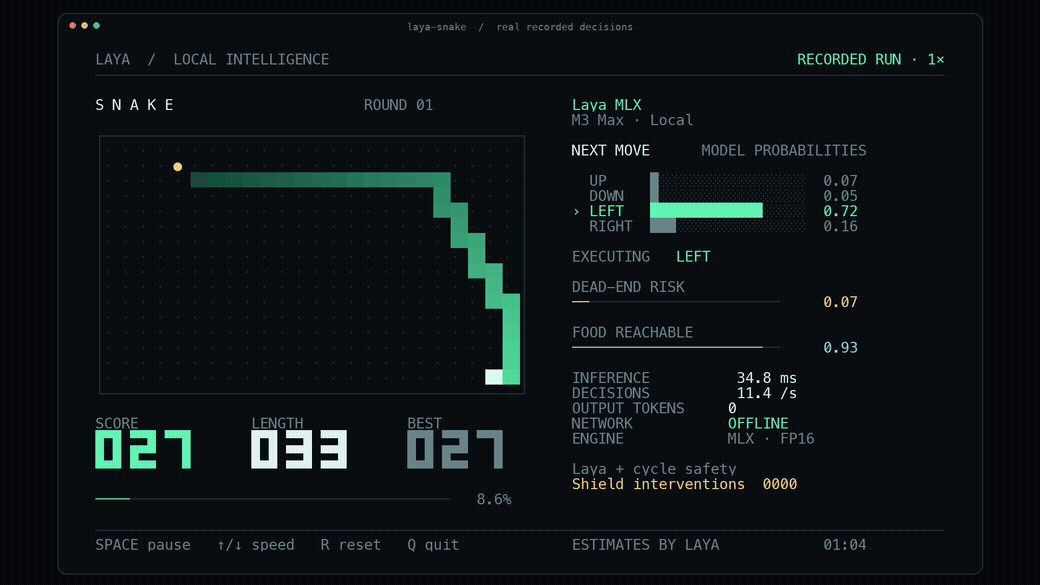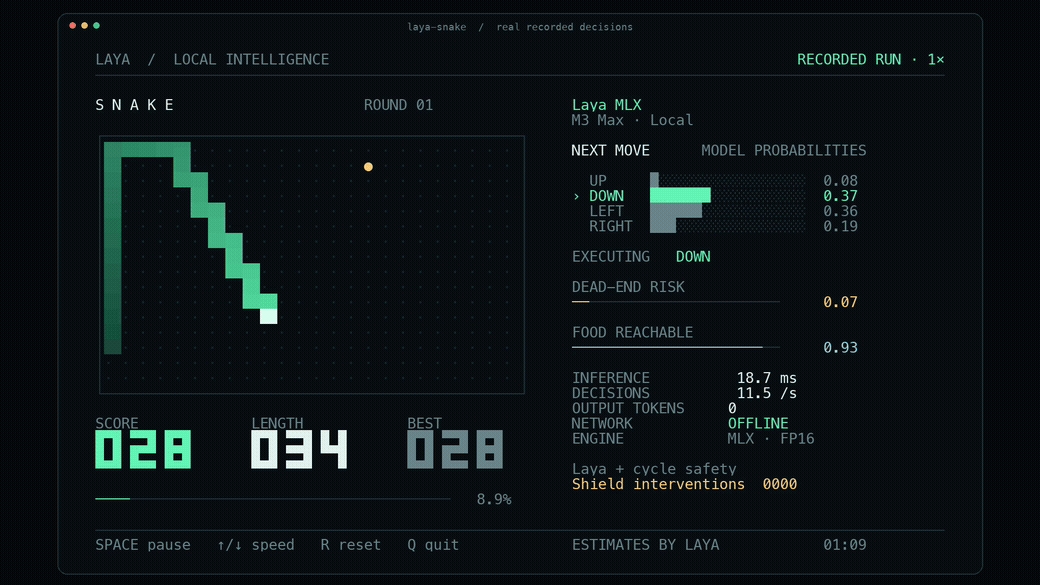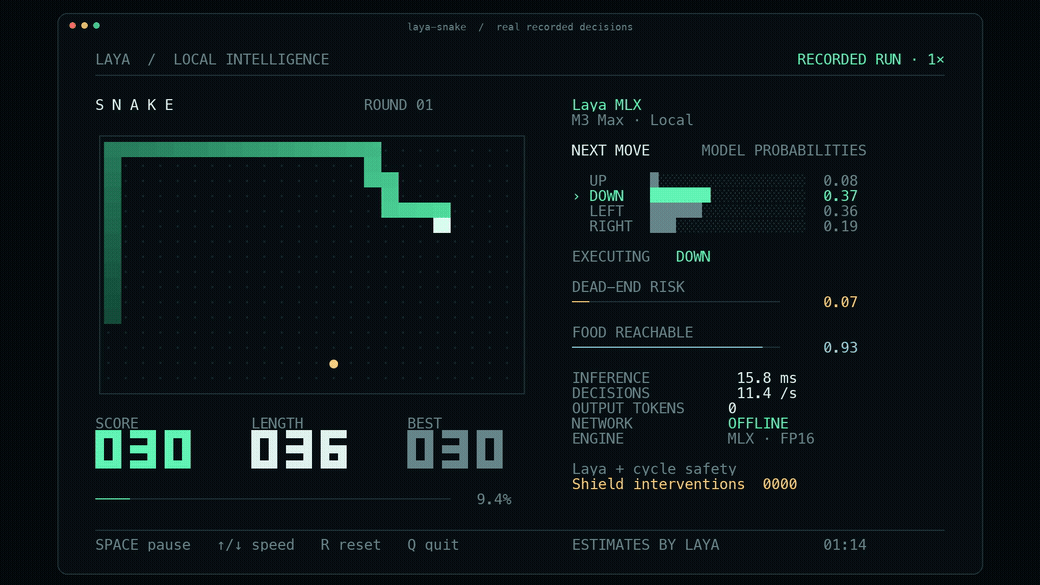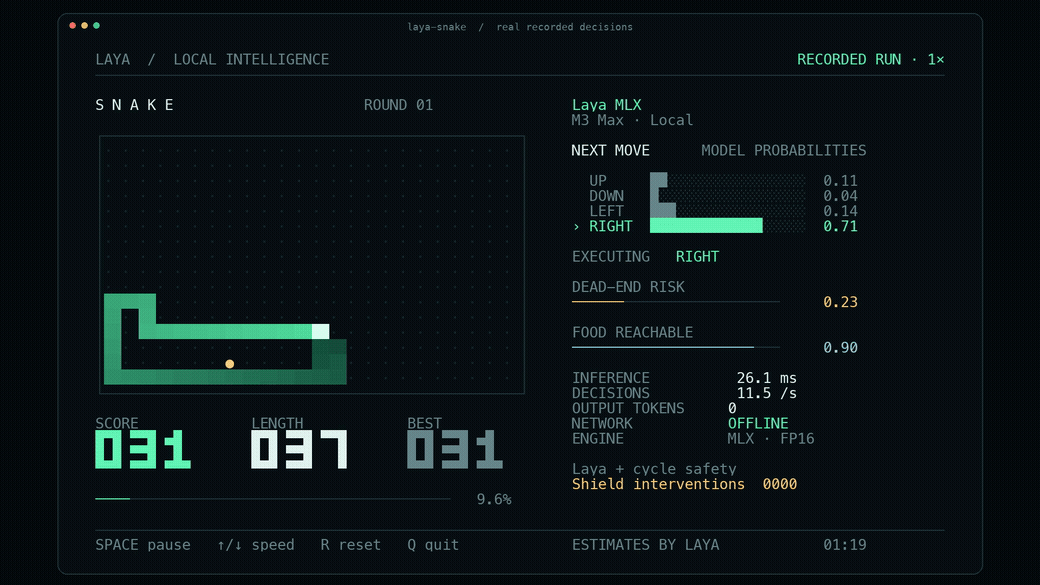
你是否遇到过这样的场景:客服工单需要自动分派到「计费」「技术」或「销售」部门;内容审核系统需在0.1秒内判断一条评论是否符合「友善度评分L3」标准;游戏AI要在帧率限制下实时决定蛇的下一步是否安全?Laya-MLX就是为这类「非生成式决策任务」而生的轻量级本地推理引擎——它专精于结构化选择(choice)、量化打分(score)和真值判断(noul),在M3 Max上平均仅需7.4毫秒即可返回结果,全程离线、零云调用、无文本生成、不加载PyTorch或Hugging Face Transformers。
核心功能
- 毫秒级结构化决策:解决传统大模型「杀鸡用牛刀」的问题——当业务只需从几个预设选项中选一个(如「退款申请应转交哪个部门?」),Laya-MLX跳过token-by-token解码,直接输出带概率的结构化答案,P50延迟低至7.39ms(多语言版)。
- 完全本地化运行:解决隐私敏感场景下的合规瓶颈——模型权重、推理过程、输入数据全程驻留设备内存,无需联网调用API,不上传任何用户文本,满足金融、医疗等强监管行业对数据不出域的要求。
- Apple Silicon深度优化:解决Mac用户长期面临的AI部署困境——原生适配MLX框架,充分利用M系列芯片GPU(如M3 Max的40核GPU)与统一内存架构,避免CPU-GPU频繁拷贝,实测峰值显存占用仅687.6 MiB(多语言版)。
- 类型化问题建模:解决通用LLM输出不可控的问题——通过JSON Schema明确定义问题类型(
choice/score/noul),强制模型输出结构化结果,杜绝「答非所问」「自由发挥」,保障下游系统可稳定解析。 - 零输出token设计:解决文本生成类模型的冗余开销——不生成任何中间文本或JSON字符串,直接计算并返回Python字典格式的概率分布,省去prompt工程、正则解析、JSON反序列化等环节,端到端更可靠。
- 编译加速与前缀复用:解决高频决策场景的性能瓶颈——启用
--optimize --max-speed后,Snake游戏实测达75.40 moves/s,比默认模式快6.5%,且全程零内存泄漏,适合嵌入实时交互系统。 - 跨精度高保真验证:解决量化部署中的精度丢失焦虑——所有checkpoint在FP32/FP16下均通过63道验证题全对(378/378),100次重复调用内存增长为零,确保生产环境结果可预期。
- 开箱即用的终端Demo:解决学习成本高的问题——一条命令
laya-snake即可启动可视化贪吃蛇游戏,每个移动指令都触发一次真实决策,直观感受延迟、安全校验层与实时响应能力。
技术亮点
- 纯MLX栈重构,剔除PyTorch依赖:项目完全基于Apple官方MLX框架实现,不引入PyTorch、Transformers或Accelerate,大幅降低macOS二进制体积与依赖冲突风险;安装包自动匹配macOS 14/15/26对应wheel,规避常见兼容性报错。
- 双向编码器+决策头架构:摒弃自回归解码范式,采用类似BERT的双向Transformer Encoder提取语义表征,再接轻量级分类头(choice)、回归头(score)或二分类头(noul),实现「状态+问题→决策」的单次前向传播。
- Typed Decision Prompting协议:定义了一套简洁的Python字典接口(如
{"department": {"type": "choice", "criteria": ["billing", "technical"]}}),将业务逻辑与模型能力解耦,开发者无需写prompt模板,只需描述问题结构。 - 内存与计算协同优化:针对Apple Silicon统一内存特性,显式控制张量生命周期,实测单次短问题推理峰值显存仅943.6 MiB(421M模型),支持在M2 MacBook Air等中端设备上流畅运行。
- 端到端延迟精确归因:基准测试明确排除模型加载时间,计入tokenization、tensor同步、校准、结果格式化等全部环节,P50/P95数据均来自真实环境(macOS 27.2 + Python 3.12.13 + MLX 0.32.2),拒绝「实验室最优值」误导。
适合哪些人用
本项目特别适合三类技术实践者:
- 企业内部工具开发者:例如某电商公司需将每日2万条客诉自动路由至对应部门。使用Laya-MLX可构建本地化分单服务,单机QPS达395(多语言版),延迟稳定<10ms,避免云API调用成本与网络抖动风险。
- 边缘AI应用工程师:如智能硬件团队为新款MacBook开发离线版「会议纪要情绪评分」插件,要求实时分析语音转文字结果并输出「积极/中性/消极」概率,Laya-MLX的
score类型完美匹配该需求。 - 教育/研究领域实践者:高校AI课程教师可用
laya-snake作为教学演示案例——学生能直观看到AI如何在毫秒级做出安全决策,同时通过修改criteria快速实验不同决策逻辑,理解「结构化推理」与「文本生成」的本质差异。
快速上手
仅需两步即可运行:
- 安装:执行
pip install laya-mlx(推荐Python 3.11+,macOS 14+) - 调用:复制以下代码,首次运行会自动下载Hugging Face模型(约1.2GB)
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx")  # 英文版
# 或 agent = laya.load("aac6fef/laya-multilingual-mlx")  # 多语言版

result = agent.predict(
    "订单号#88921重复扣款,请立即处理。",
    {
        "action": {
            "type": "choice",
            "instructions": "应执行什么操作?",
            "criteria": ["退款", "核实", "忽略"]
        }
    }
)
print(result["answers"]["action"])  # 输出:{'refund': 0.92, 'verify': 0.07, 'ignore': 0.01}
想体验可视化效果?安装demo模块:pip install 'laya-mlx[demo]',然后运行laya-snake(终端尺寸≥104×35),空格键暂停,↑↓调节速度,R重置游戏。
同类对比 / 注意事项
- vs 传统LLM API(如OpenAI/Gemini):Laya-MLX不生成文本,无token消耗,无网络延迟,无隐私泄露风险,但也不支持开放式问答——它是「专用决策芯片」,而非「通用大脑」。
- vs PyTorch版Laya或HuggingFace Transformers:MLX版本在M系列芯片上延迟降低40%+,内存占用减少25%,且无需conda环境或CUDA驱动,但暂不支持Windows/Linux(MLX尚未官方支持)。
- 注意事项:首次
laya.load()会下载模型(需科学上网或手动hf download);多语言版虽延迟更低,但对中文长句理解略逊于英文版;当前仅支持单轮决策,暂无stateful对话记忆能力。
项目信息
Native MLX runtime for Laya typed decision models — 7–14 ms short decisions on M3 Max. No text generation, PyTorch, or cloud API.
⭐
6.1k
6.1k
Stars
🔀
467
Forks
467
Forks
Python
📄
Apache-2.0
Apache-2.0
编程语言:Python|Star 数:6122|开源协议:Apache-2.0|GitHub 项目地址
如果你需要在Mac上实现「快、稳、私、准」的结构化决策能力,而不是又一个慢吞吞的聊天机器人,Laya-MLX是目前最务实的选择。