别再手动复制粘贴网页内容了。
你花半小时整理的新闻标题、商品参数、招聘要求,其实可以交给一个工具自动干完——而且不用注册账号、不上传数据、不按条收费。
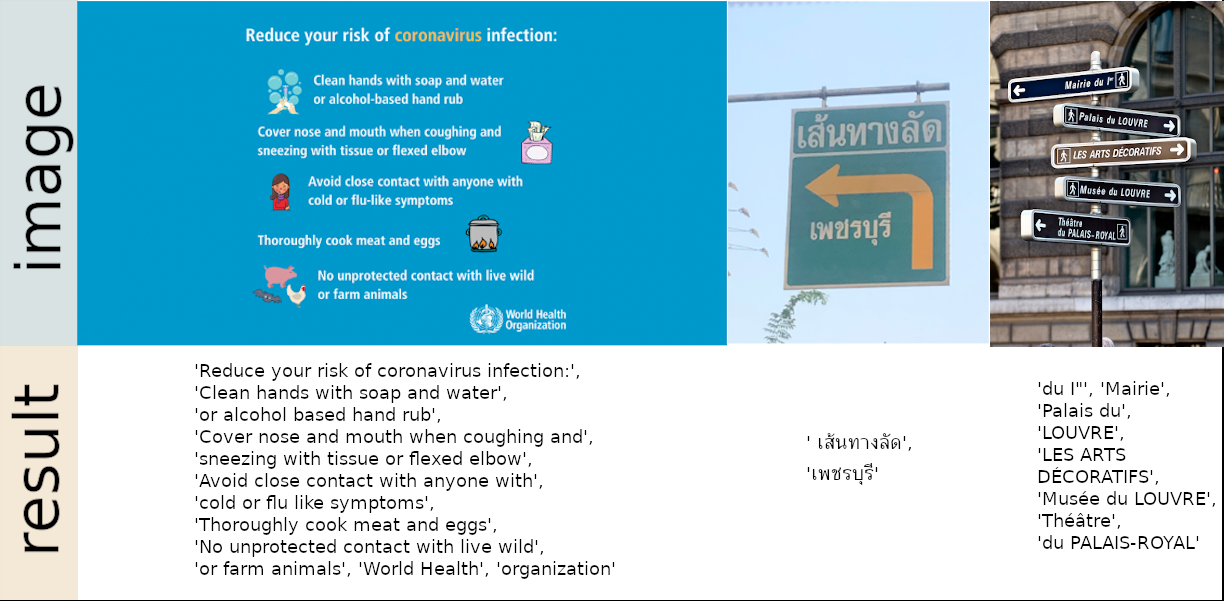
它不叫「爬虫」,也不需要写代码。你只要告诉它「我要哪几类信息」,它就打开网页、读内容、结构化输出,像人一样理解页面。
它替你省掉了什么
市面上没有直接对标的名字,但它解决的是真实付费场景:比如企业采购部门每天要从几十个供应商网站扒产品型号和报价;运营要定时抓取竞品活动页文案;研究员得汇总上百篇论文摘要。
它不卖服务,只给你一个能自己跑起来的工具。
这类需求,通常靠外包写脚本(一次几千)、或买现成SaaS(月费300–800元起)、或订阅AI自动化平台(年费上千)。而这个项目完全开源,MIT协议,允许商用。
价格直接砍到零。
它能干什么
- 你给它一个网址,比如豆瓣电影页,再定义「片名、评分、导演、上映年份」这几个字段,它就能把整页信息自动抽出来,生成标准JSON,直接导入Excel或数据库。字段定义用Zod语法,比如
z.string().min(1)确保片名不为空,z.number().int().positive()限定评分是正整数。 - 支持GPT、Claude、Gemini、Qwen甚至本地Llama模型,也就是说,你用自己已有的API密钥就能跑,不用额外买算力。每个模型对应独立初始化方式,比如Anthropic需调用
anthropic('claude-3-5-sonnet-20240620'),参数名必须严格匹配官方模型ID。 - 不只是文字:它还能截取网页截图,喂给多模态模型识别图中表格或价格标签,对电商比价、财报截图解析特别实用。启用
format: 'image'后,Playwright会自动生成全屏截图并传入LLM上下文。 - 格式灵活,可选HTML原样、纯文本、Markdown甚至Readability优化后的干净正文,遇到排版混乱的新闻站,也能稳稳提取核心内容。比如设
format: 'text'时,底层调用Mozilla的Readability.js库,自动过滤广告栏、导航菜单等干扰区块。 - 支持流式输出,边分析边返回结果。比如抓10条新闻,第3条刚识别完就能看到,不用等全部跑完才出结果。调用
scraper.stream()后,返回的是AsyncIterable对象,配合for await逐段消费。 - 所有操作都在你本地电脑完成:浏览器用Playwright启动,LLM调用走你自己的API,数据不经过任何第三方服务器。Playwright默认使用无头Chromium,无需手动安装浏览器,npm install时自动下载对应二进制。
怎么开始用
- 先装Docker(官网下载安装包,Windows/macOS都有图形界面,点几下就装好),这是最省事的方式;如果你熟悉Node.js,也可以用npm全局安装,但Docker更稳定。实际只需执行
npm i zod playwright llm-scraper三行命令,Playwright会自动适配系统环境。 - 去OpenAI、Anthropic或Google Cloud申请一个免费API密钥(新用户通常送$5额度,够试几十次),填进配置文件里;不想用国外服务?它也支持Groq或本地Ollama,文档里有具体命令。例如Groq需额外设置
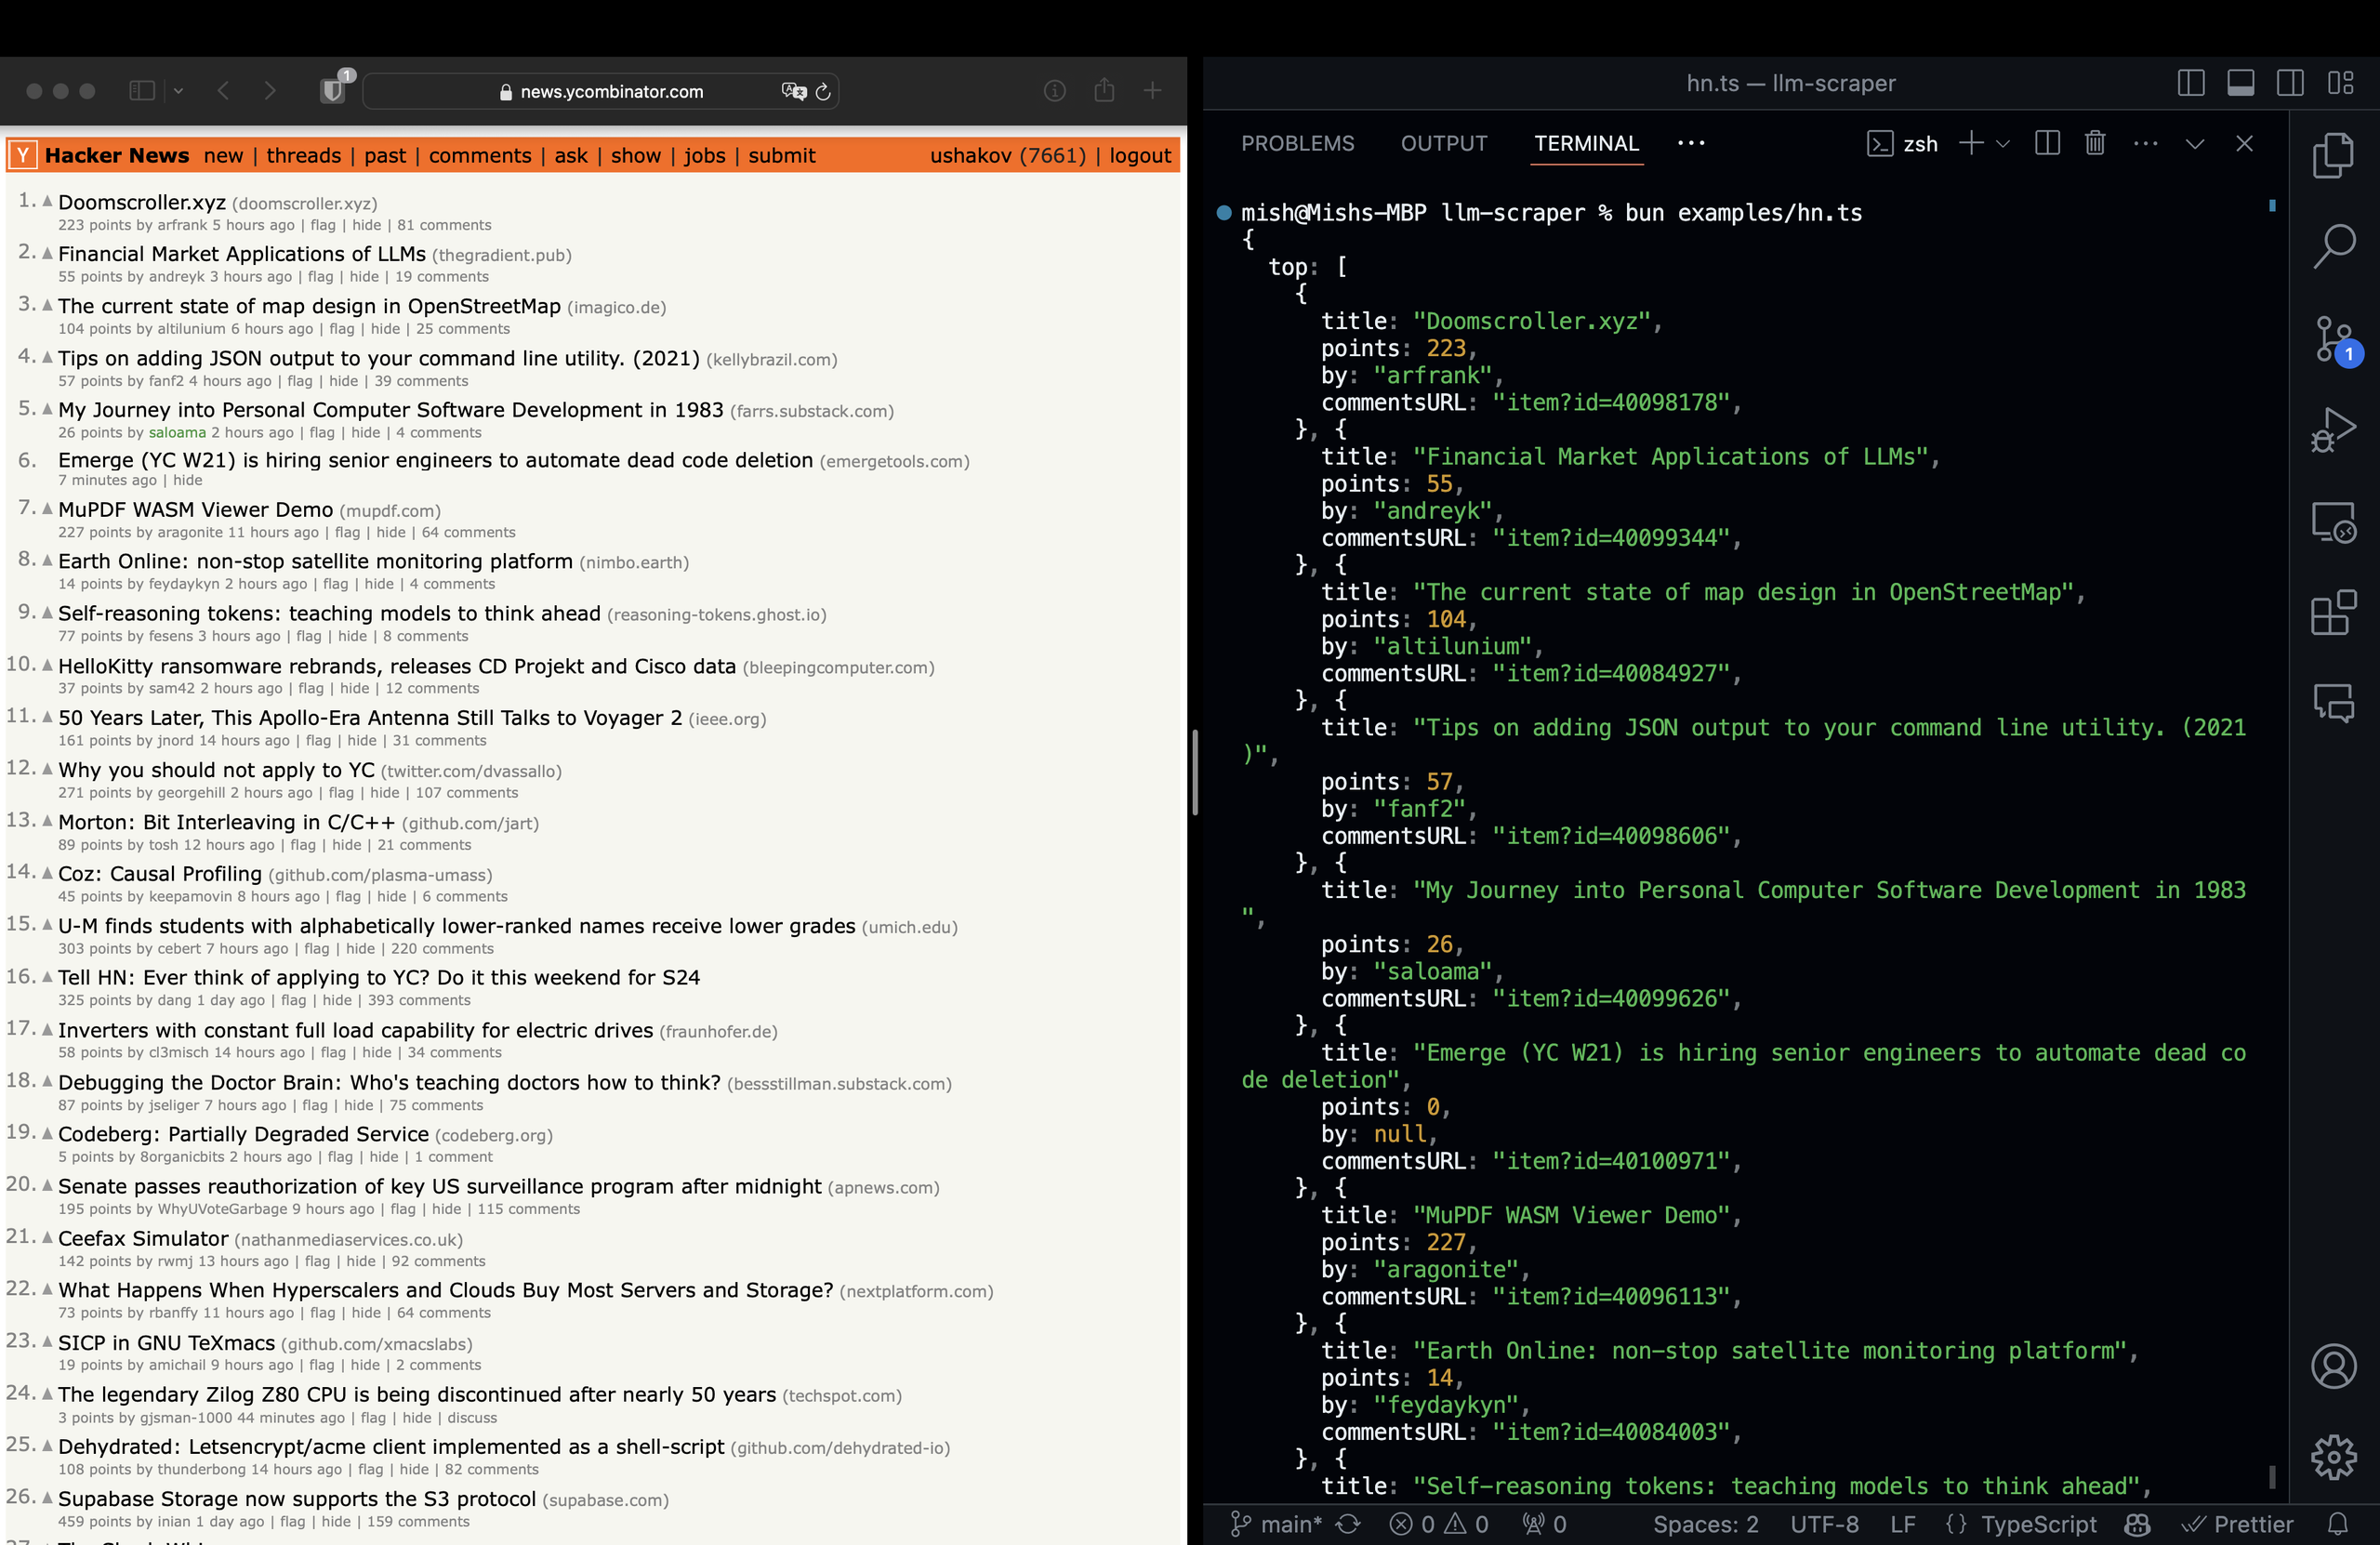
baseURL和GROQ_API_KEY环境变量,Ollama则依赖本地ollama serve进程已启动。 - 运行官方提供的示例脚本(GitHub仓库里examples文件夹下就有现成的Hacker News抓取代码),改两行网址和字段定义,保存后终端敲
node index.js,几秒后就能看到结构化结果打印出来。示例中schema用Zod定义为含5项的数组,每项包含title、points等键,LLM会严格按此结构输出,不会多也不会少。
项目信息
📦
mishushakov/llm-scraper
GitHub
mishushakov/llm-scraper
GitHub
Turn any webpage into structured data using LLMs
你用过类似的免费工具吗?评论区聊聊,我挑几个下期专门写。