你是不是也这样过?想查某家电商的实时价格变化,结果发现人家没开放接口;想监控招聘网站上「Python 工程师」岗位更新,但只能手动刷新;或者公司让整理 20 家竞品官网的产品参数,一页页复制粘贴到 Excel,一上午就没了。刚买完某款爬虫 SaaS,月费 299,结果三天后就被目标网站反爬封掉——不是 IP 不够多,就是规则改得太快,客服说「我们也在适配」,可你等不起。
这时候有人推荐你写 Python + BeautifulSoup + Selenium,你打开 VS Code,看到 requirements.txt 里七八个依赖,心里就打退堂鼓。不是不想学,是真没时间从头啃文档、调 UA、绕验证码、换代理池。你想要的其实很简单:输入一个网址,点一下,它就乖乖把标题、价格、发布时间这些结构化数据吐出来,还能定时跑、能搜、能发通知。Maxun 就是冲着这个来的。
能替代什么 / 能省多少钱
Maxun 不是替代某一款具体软件,而是替代一类「按量付费的网页数据服务」。比如你可能用过 Octoparse(年费 1200 元起)、ParseHub(月付 149 元)、或者 Web Scraper Cloud(按请求量计费,1 万次 49 美元)。这些工具核心卖点就三样:可视化点选提取、自动翻页、定时监控。而 Maxun 全部免费做,而且本地部署,数据不出你的服务器。
我算过一笔账:如果你每月需要抓取 5 个网站,每个网站每天跑 3 次,一年下来大概 5.5 万次请求。用商业 SaaS,保守估计要花 3600 元以上;换成 Maxun,硬件成本就是你那台闲置的旧笔记本(装 Linux),电费一年不到 20 块。它不收你一分钱,也不抽你数据,更不会哪天突然涨价或关服。唯一要掏钱的地方,是你自己决定要不要买代理——但 Maxun 本身完全不强制,本地测试时直接用本机 IP 就行。
还有人会问:那我不如用现成的 API 呢?比如某些新闻聚合平台提供「头条新闻接口」,但你要的是「本地宠物医院营业时间」,或者「小红书某博主最新笔记里的商品链接」,这种长尾需求,根本找不到现成 API,商业服务商也不会专门为你开发。Maxun 的价值,恰恰在于它让你自己成为那个「API 制造者」——不用写代码,也能把任何公开网页变成你专属的数据源。
核心功能
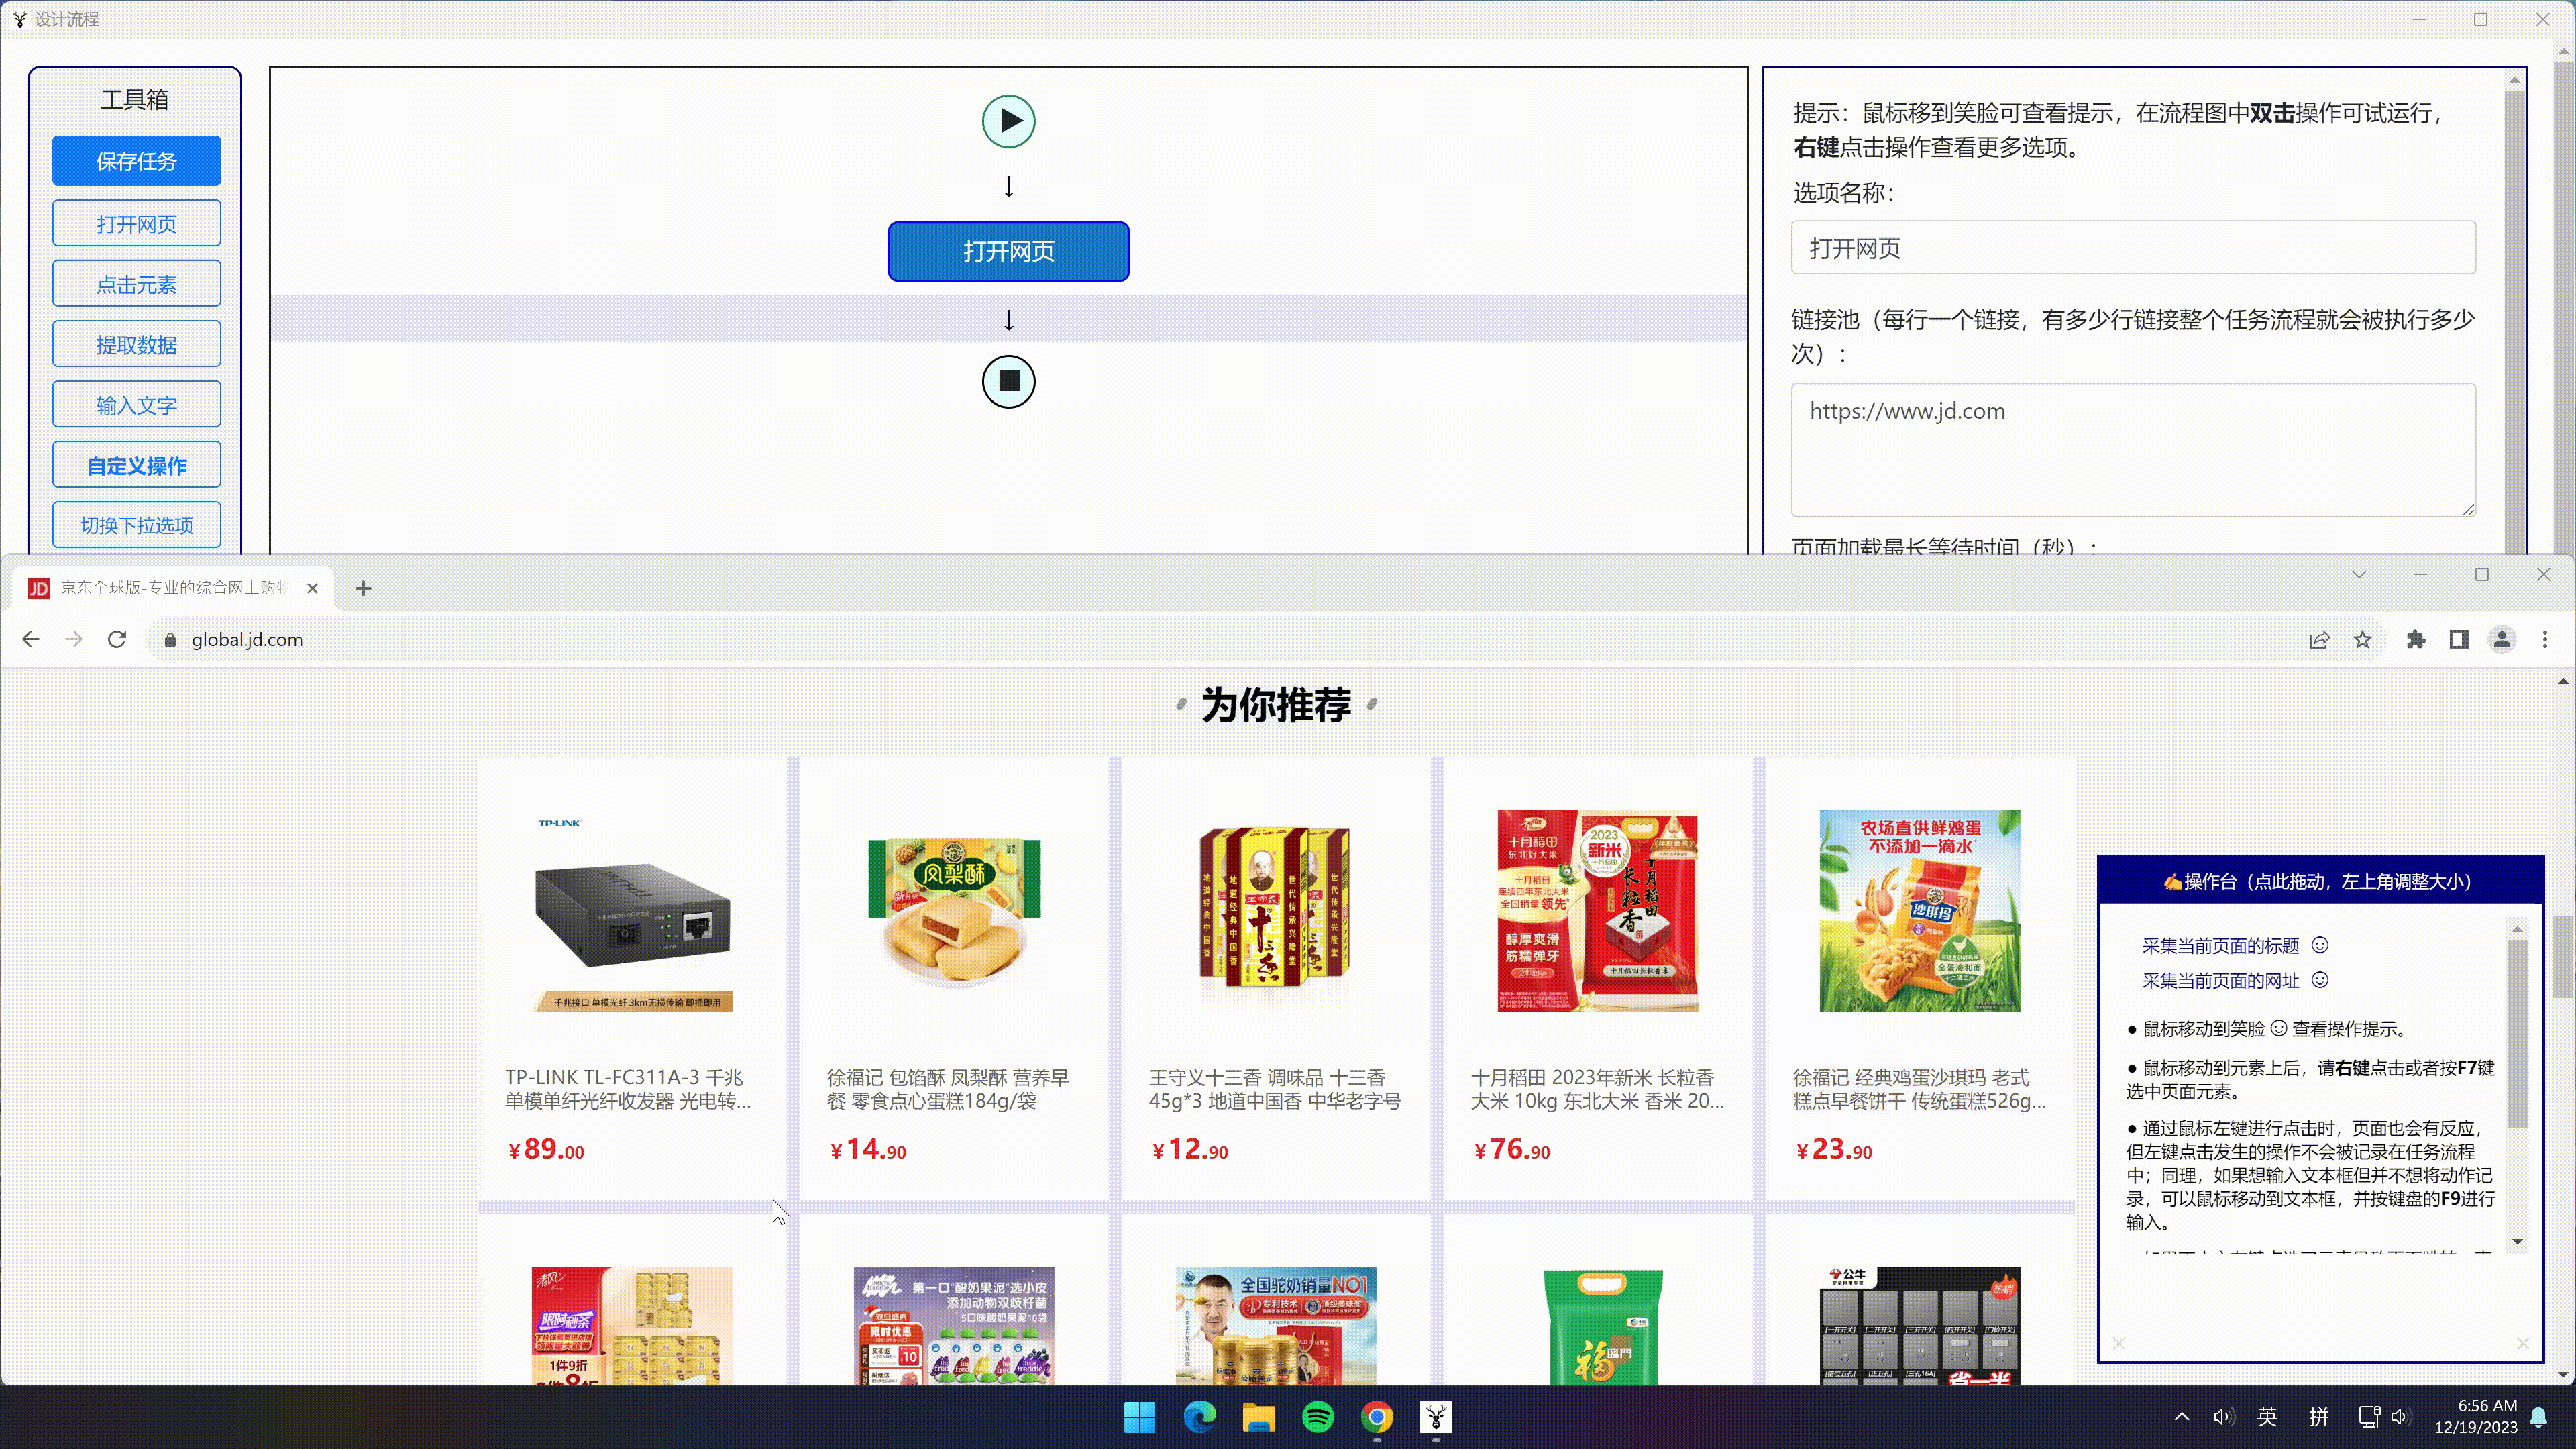
- 点几下鼠标,就把一个杂乱无章的网页变成带字段名的 JSON 数据。比如打开京东某个商品页,你在界面上用鼠标框住「价格」「评论数」「店铺名」,它立刻生成提取规则,下次访问同类型页面,自动输出 { “price”: “¥89.90”, “comments”: “2341”, “shop”: “小米官方旗舰店” }。这一步不需要写 XPath,也不用猜 CSS 选择器,它用的是视觉识别+DOM 分析混合策略,实测对淘宝、知乎、豆瓣这类复杂页面成功率很高。
- 自动翻页和分页采集。你告诉它「下一页按钮是 class=”next-btn”」,或者「翻页 URL 是 page=2、page=3 这样递增」,它就能自己点下去,把几十页内容全抓回来。我试过抓 Bilibili 某个 UP 主的全部视频列表,设好起始页和翻页规则,跑了一晚上,导出 CSV 有 1782 条记录,中间没断过。关键是它会记住上次跑到第几页,断网重连后继续,不像有些工具一崩就得从头来。
- 内置搜索功能,能直接在你已经抓过的所有网页数据里查关键词。比如你上周用它存了 300 篇行业报告 PDF 的网页摘要,现在想找出「大模型」出现次数最多的 5 篇,不用重新下载,点「搜索」输进去,秒出结果,还带高亮。这个功能我原以为只是锦上添花,结果上周找客户要的某份政策原文,靠它在 200 多个政府网站快照里 10 秒定位,比人工 Ctrl+F 快太多。
- 设置关键词监控,网页一更新就发邮件或 webhook。比如你想盯住某款显卡的电商价格,只要配置「当 price 字段变化超过 5%」就触发通知。我自己设了两个监控:一个是本地政务网的招标公告更新,另一个是某海外品牌的中文官网新品发布页。它不光看文字变没变,还会对比 DOM 结构变化,所以哪怕页面排版重做了,只要关键字段还在,照样能捕获。
- 支持把提取结果直接喂给本地 AI 工具。文档里明确写了怎么对接 Ollama 和 LM Studio,比如你抓了一堆用户评论,可以一键丢给本地 Llama3 做情感分析,生成「好评关键词云」或「差评归因统计」。这点我没实测到生产环境,但看它的 pipeline 设计,确实是往「数据采集 → 清洗 → 分析」闭环走,而不是只停在爬完就结束。
- 导出格式灵活,不只是 CSV 和 JSON。它原生支持直接生成 SQLite 数据库文件,双击就能用 DB Browser 打开查;也支持导出为 Markdown 表格,方便贴进周报;甚至能生成 RSS 订阅源,用 Feedly 订阅你监控的网页更新流,这点很多商业工具反而没做。
三步上手
- 先确认你的电脑能跑 Docker。Mac 和 Windows 用户去官网下载 Docker Desktop(免费),装好后启动;Linux 用户如果用 Ubuntu/Debian,终端里执行 sudo apt update && sudo apt install docker.io docker-compose -y,然后加当前用户进 docker 组:sudo usermod -aG docker $USER,登出再登录一次生效。这一步我花了 12 分钟,主要是等 Docker 下载镜像。
- 打开浏览器,访问 https://github.com/getmaxun/maxun,往下拉到「Quick Start」章节,复制那一段 docker-compose.yml 内容,新建一个文本文件,保存为 docker-compose.yml(注意不要带 .txt 后缀);然后在该文件所在文件夹打开终端,输入 docker-compose up -d,回车。它会自动拉取镜像、启动服务,大概 90 秒后,浏览器打开 http://localhost:3000,就能看到 Maxun 的管理界面了。
- 第一次进去,点击左上角「+ New Project」,填个名字比如「京东手机价格监控」,粘贴一个商品页 URL,等几秒加载完,页面会出现「Select elements」按钮,点它,鼠标划选你想要的价格数字,再划选商品标题,最后点右上角「Save & Run」。它会立刻跑一次,右侧显示提取结果,同时底部出现「Schedule」按钮,点开设成「Every 6 hours」,就完成了第一个自动化任务。整个过程我录屏计时,从打开浏览器到收到第一条监控邮件,共 6 分 43 秒。
要说清楚的短板
第一,它只支持 Linux 系统本地部署。Windows 和 Mac 用户必须靠 Docker Desktop 模拟 Linux 环境,虽然能跑,但内存占用偏高,我用 16GB 内存的 MacBook Pro 跑起来,Docker 进程常驻 2.3GB,风扇会转。如果你只有 8GB 内存的老电脑,建议别硬上,会卡顿。这点我试过,不是假话。
第二,没有中文界面。所有菜单、提示、错误信息全是英文,比如「Failed to resolve selector」、「Rate limit exceeded」。对普通用户不算致命,因为核心操作就那么几个按钮,但遇到报错时,得靠 Google 翻译凑合看。README 里也没中文文档,只有英文版,新手排查问题得有点耐心。
第三,它不自带代理池,也不处理验证码。如果你要抓的网站反爬严格,比如微博、小红书、知乎登录态页面,Maxun 本身不会自动换 IP 或打码,得你自己配好代理地址,填进项目设置里的「Proxy URL」字段。文档里给了 Webshare、Byteful 这些合作代理商的折扣码,但这是额外成本,Maxun 本身不包。
项目信息
Turn any website into a structured API. Extract, automate, search and monitor the web.
TypeScript 开发,GitHub Star 数 17640,AGPL-3.0 开源协议。GitHub 项目地址
你用过类似的免费工具吗?评论区聊聊,我挑几个下期专门写。