你是不是也这样:扫个合同、拍张收据、截个网页表格,转文字就得开会员、充时长、等识别、导出还带水印?
要么用手机自带OCR——但只认横排字,竖着写的菜单、老票据、手写单子,直接罢工;要么下个大软件——动辄几百MB,还要注册、登录、联网、看广告。
其实不用这么麻烦。有个项目,模型加起来才4.7M,比一张高清截图还小,却能把竖排中文、模糊小字、带框表格全认出来。
它替你省掉了什么
它不替代某一个具体收费软件,而是绕开了整个“OCR要花钱”的默认路径。市面上主流OCR服务,按次收费的每张1-3元,包月的68-128元/月,企业API调用更贵,而它完全免费,也不需要联网上传你的图片。
数据全程不出你的电脑或手机。
你拍的发票、扫描的合同、截图的聊天记录,识别过程全部在本地完成。没有账号、没有云端处理、不传图、不存记录。官方明确说明:支持CPU推理,无需显卡,也不依赖CUDA。
价格直接砍到零。
核心功能
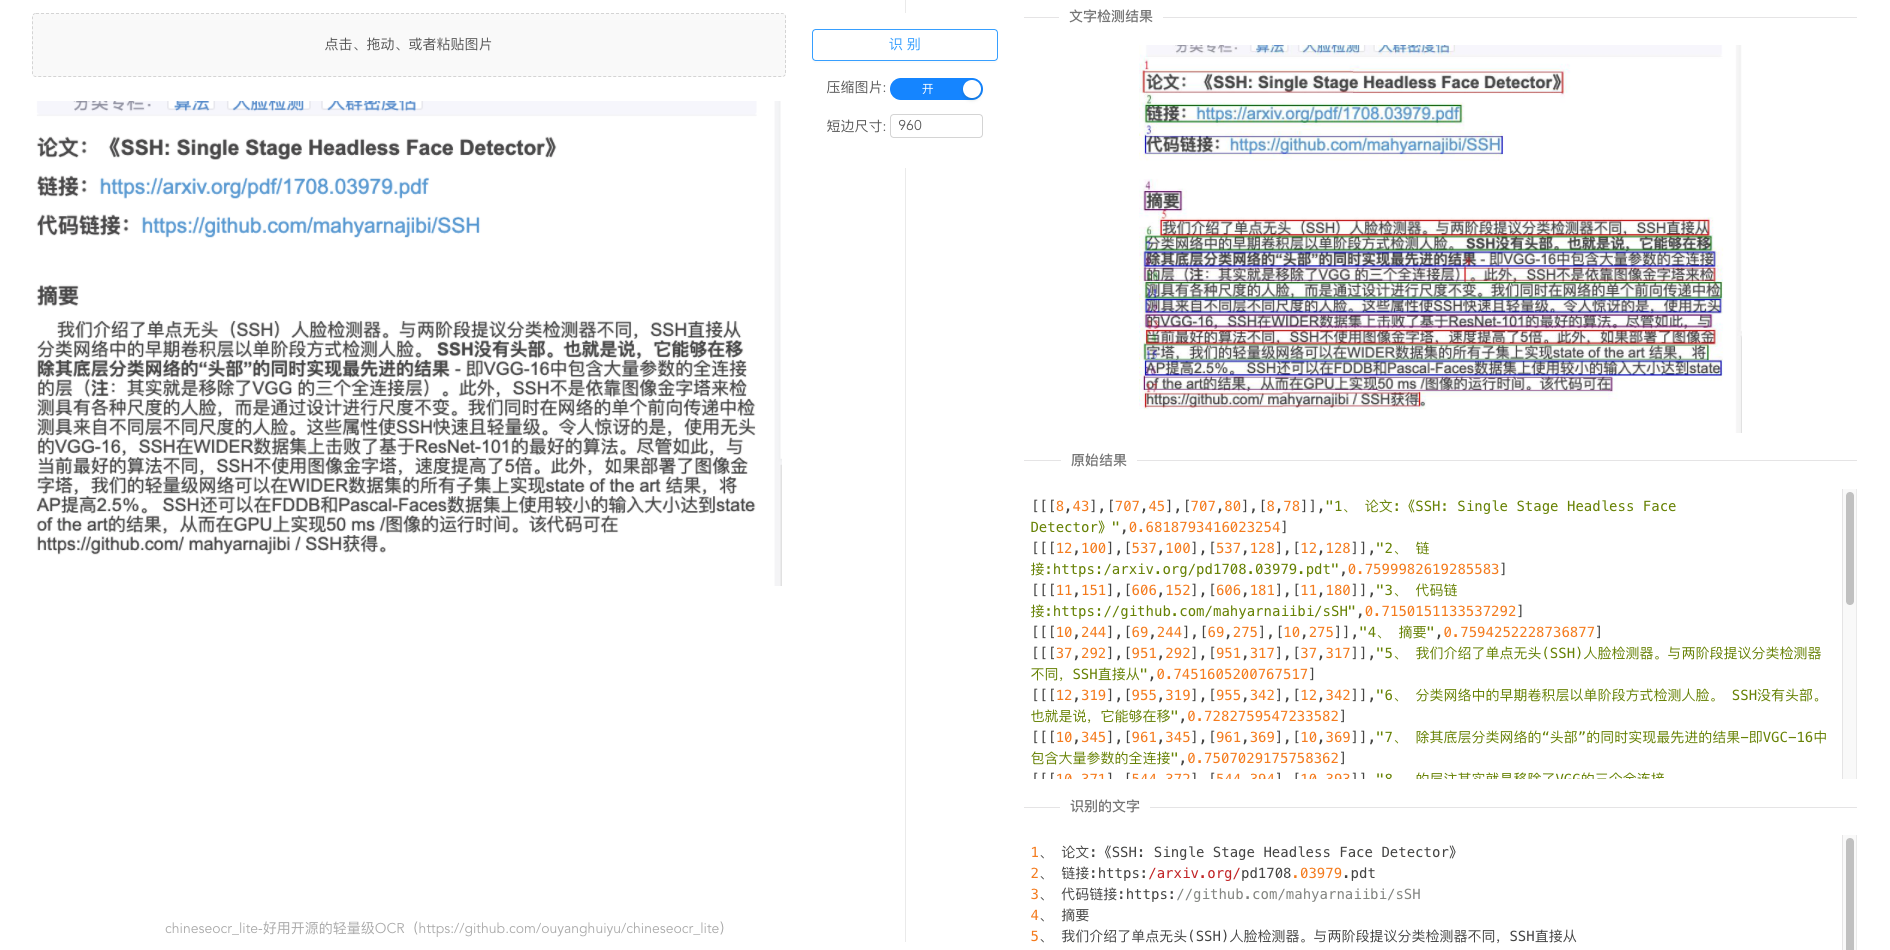
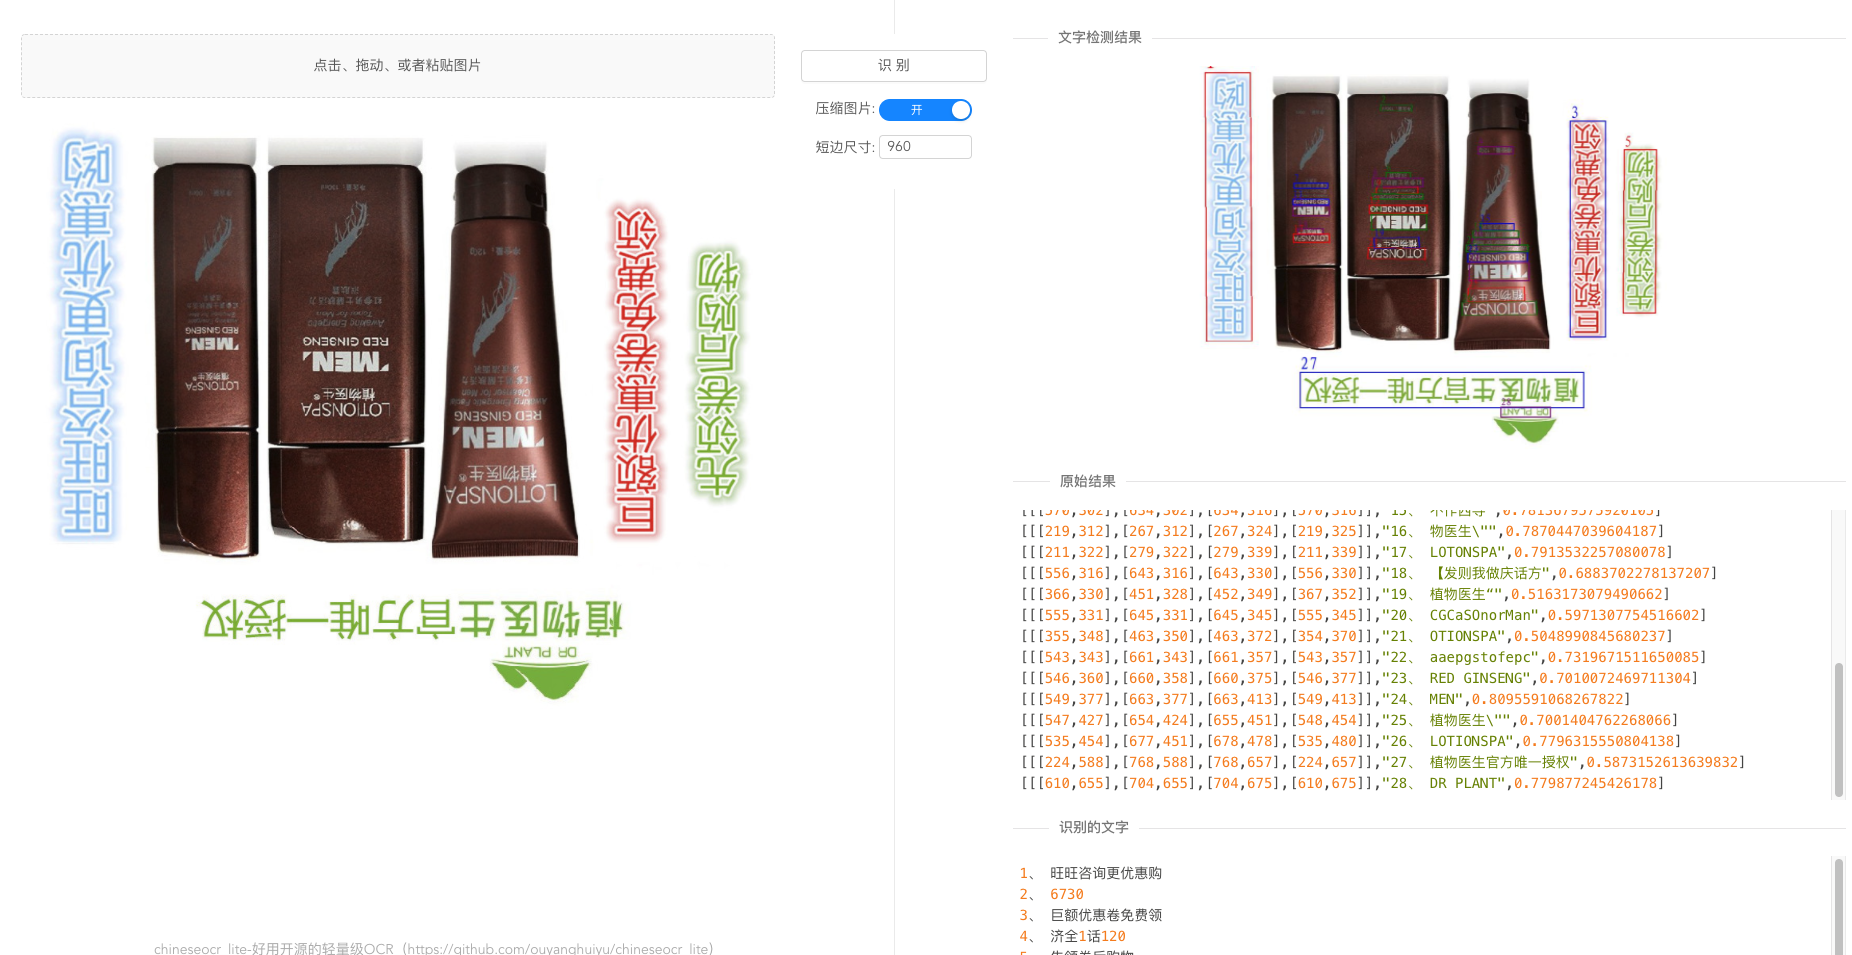
- 专为中文优化,能准确识别竖排文字,比如传统菜谱、古籍影印、银行回单、港澳台证件上的竖排姓名栏,不用手动旋转图片再识别。检测模块
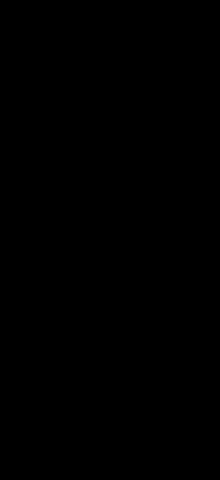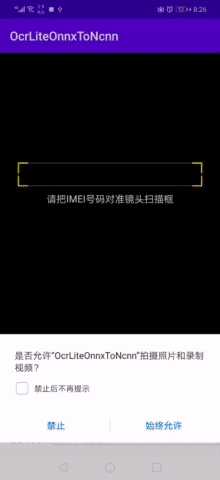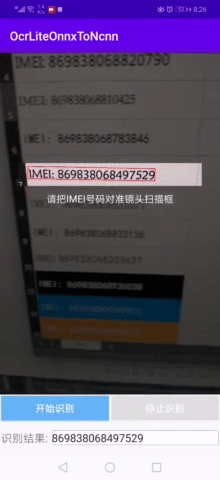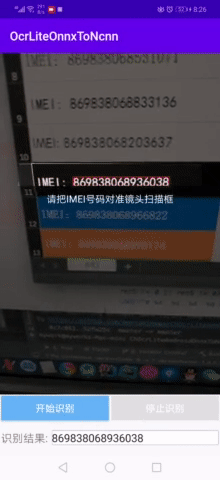
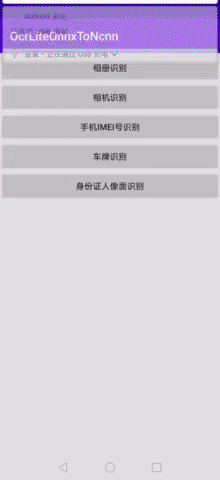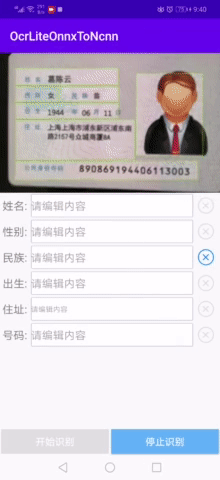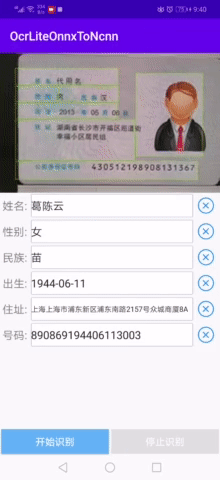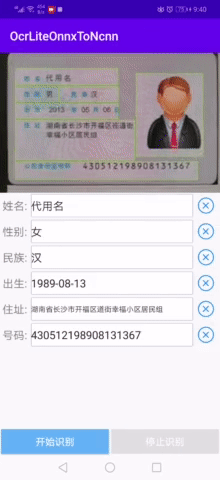
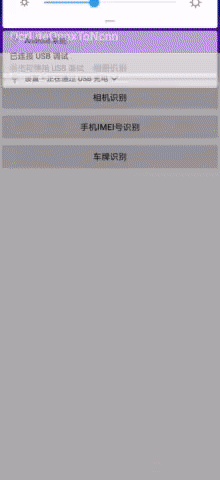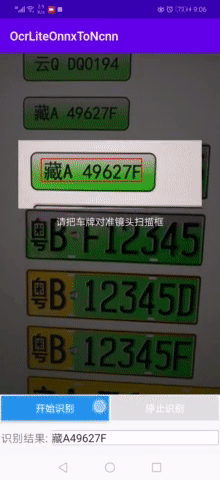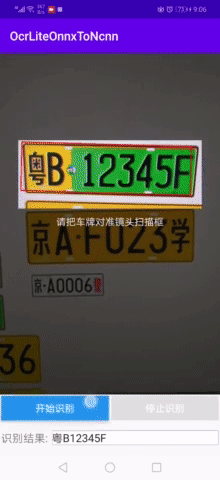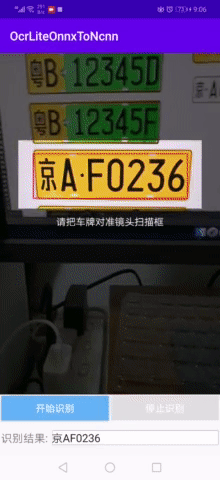
dbnet.onnx对密集小字和倾斜排版做了针对性适配,识别模块crnn_lite_lstm.onnx的字符集覆盖 GB2312 全部常用汉字及标点,不含英文时识别更稳。 - 轻量到能塞进手机APP里:Android和iOS都有现成Demo,模型文件已打包进安装包,装完即用,不额外下载资源。Android Demo 直接调用
models/下的 ONNX 文件,启动后不联网、不申请存储权限,仅需相机和读取本地图片权限。 - 支持命令行批量处理:拖一张图进去,秒出JSON结果,字段清晰(全文、每段文字、坐标框、置信度),适合配合脚本自动整理报销单、归档扫描件。例如用 Windows 批处理遍历文件夹:
for %i in (*.jpg) do chineseocr "%i" --output "%~ni.json",就能给所有发票生成结构化结果。 - Web界面开箱即用:运行一条命令,浏览器打开localhost:8089,上传图片、点识别、复制文字,整个流程三步以内,连鼠标都不用多点两次。前端页面由 Tornado 框架渲染,不依赖外部CDN,所有JS/CSS都内置在
backend/static/目录中,断网也能用。 - 对老旧设备友好:实测在2015年的MacBook Air和千元安卓机上都能跑起来,官方推荐环境只要Python 3.6+和普通CPU,没提内存要求,说明吃资源极轻。CLI 默认启用
--compress 960参数,把图片短边缩放到960像素后再送入模型,既保精度又降耗时。 - 识别结果带定位框:不只是输出文字,还能返回每个文本块在原图中的四角坐标,方便做后续标注、裁剪、或对接PDF重排工具。坐标格式是顺时针四个顶点的
[x,y]列表,可直接喂给 OpenCV 的cv2.polylines()或 PDF 工具库如pdfplumber做区域提取。
怎么开始用
- 去GitHub搜chineseocr_lite,进DayBreak-u的仓库主页,点绿色「Code」按钮下载ZIP包,解压到桌面就行,不用Git,不用命令行拉代码。解压后你会看到
backend/、models/、test_imgs/等文件夹,结构一目了然。 - 确保电脑已安装Python 3.6或更高版本(Windows/macOS/Linux都行),然后双击运行解压文件夹里的
backend/main.py,会自动弹出终端窗口并显示“server is running: 127.0.0.1:8089”。如果提示缺模块,就先打开命令行进入该目录,执行pip install -r requirements.txt安装依赖。 - 打开浏览器,访问http://127.0.0.1:8089,上传任意一张含中文的图片,点击识别,文字立刻出现在右边,可一键复制。页面右上角有「清空」按钮,左下角显示本次识别耗时,所有操作都在当前页面完成,无跳转、无弹窗。
项目信息
📦
DayBreak-u/chineseocr_lite
GitHub
DayBreak-u/chineseocr_lite
GitHub
超轻量级中文ocr,支持竖排文字识别, 支持ncnn、mnn、tnn推理 ( dbnet(1.8M) + crnn(2.5M) + anglenet(378KB)) 总模型仅4.7M
所有模型文件均来自公开训练流程,不包含任何第三方闭源组件。项目结构清晰分层,dbnet/、crnn/、angnet/ 各自独立,便于理解原理或替换模块。配置项集中在 config.py,比如修改检测阈值、调整识别最大长度、开关方向校正,改几行就能生效。
如果你只需要快速识别,Web 页面最省事;想自动化处理,CLI 是主力;想集成进自有应用,各端 Demo 提供了可直接参考的调用范式。没有隐藏门槛,也没有强制绑定。