你让AI查公司合同里“谁”能签章,它真去翻员工花名册找名字;
你问“What是第二步”,它以为你在问“什么”,结果答一堆流程定义;
这不是AI笨,是它根本没和你共享同一套“词典”——而你现在靠人工核对、反复改提示词、买高价定制服务来补这个洞。
它替你省掉了什么
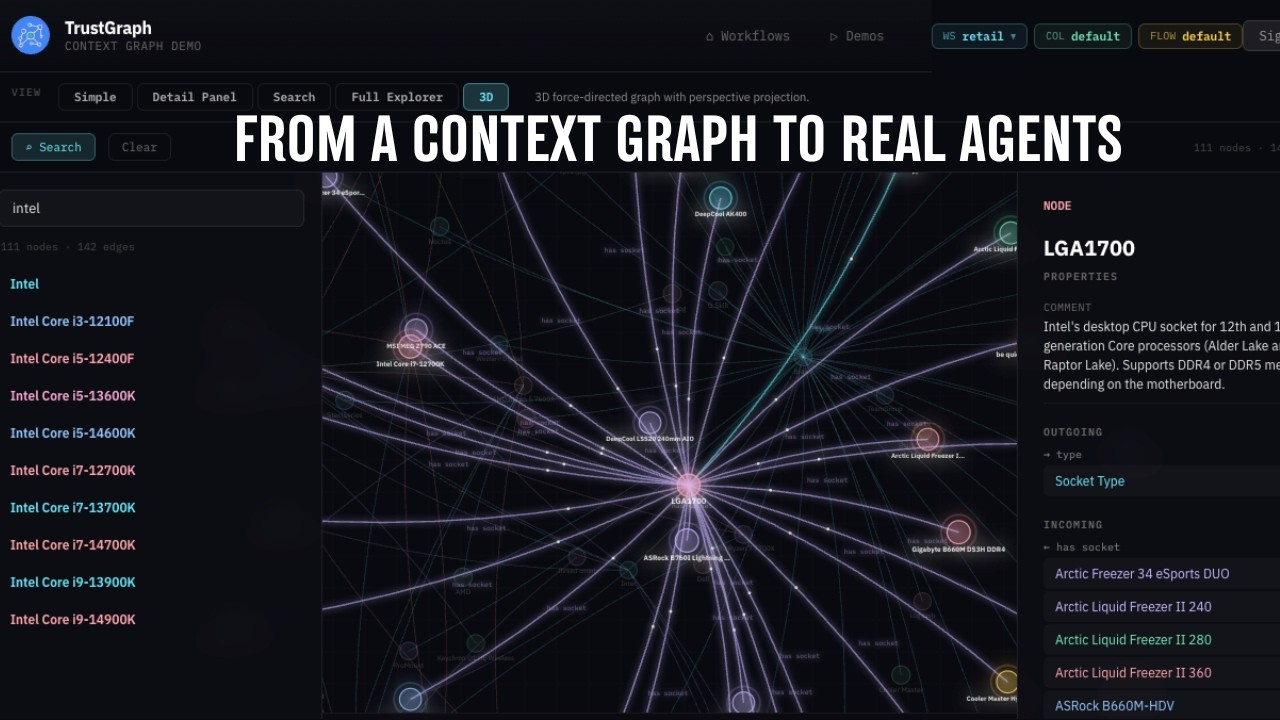
TrustGraph 不替代某个具体软件,它替代的是企业里最烧钱的一类“翻译岗”:
让AI听懂“Who”是人名,不是疑问词
比如银行要让AI审核贷款申请,传统做法得雇咨询公司建规则引擎+训练私有模型,单次落地常超30万元;
或者用商业RAG工具加人工调优,每年续费5-8万,还卡在“关键词匹配不准”上反复返工;
TrustGraph 把这套语义校准能力做成开箱即用的平台,价格直接砍到零。
它能干什么
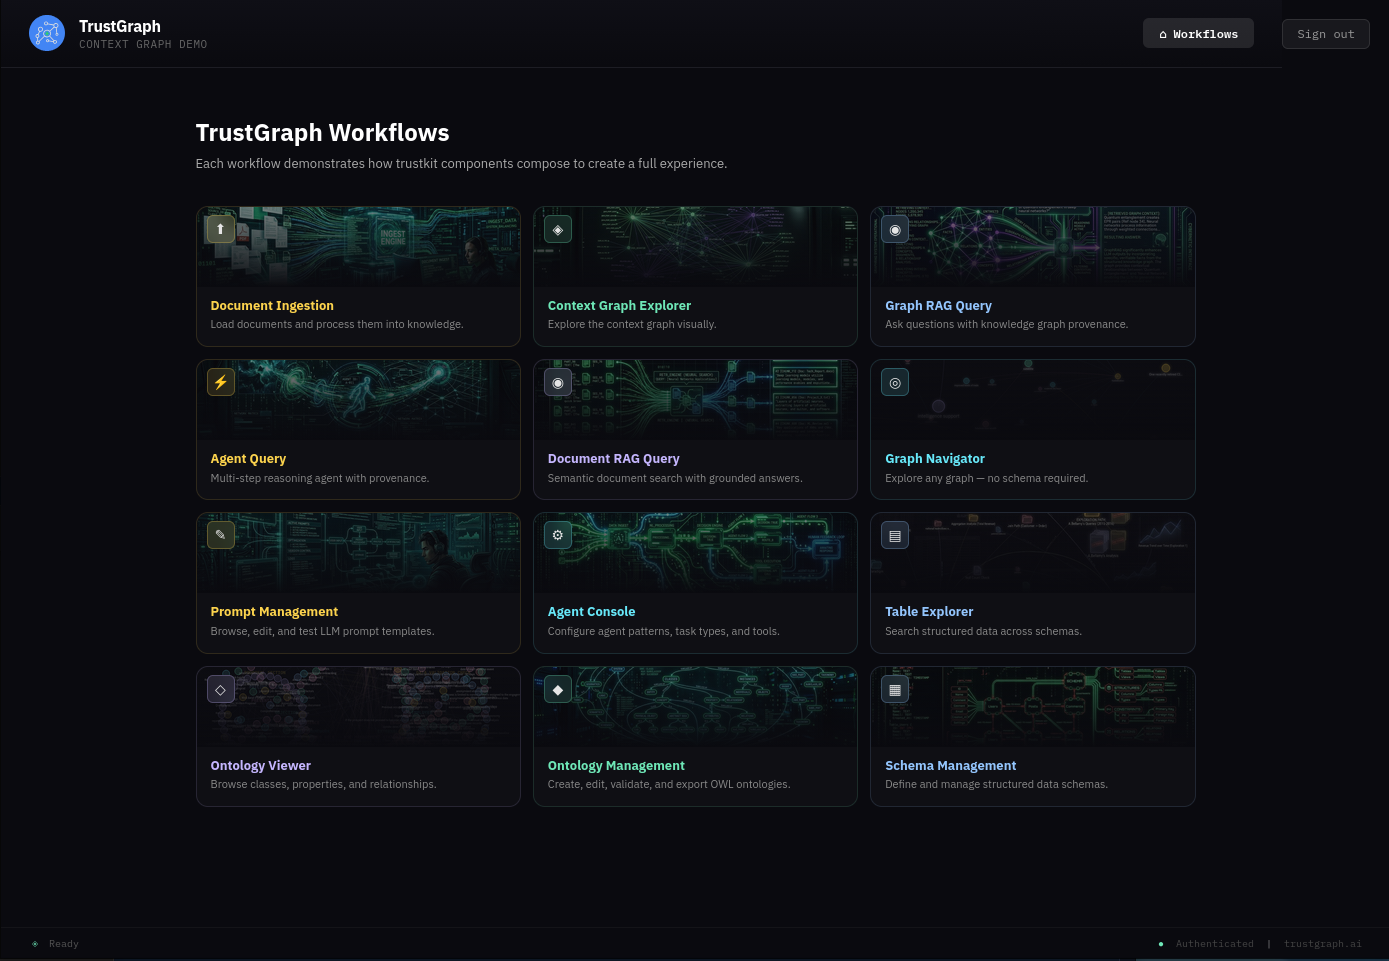
- 当你上传一份采购制度文档,TrustGraph 能自动识别出“采购员”“审批人”“金额阈值”这些角色和条件,并把它们变成机器可验证的规则,而不是堆在PDF里等人工翻。它会逐段解析文本,对照OWL本体中预定义的类(如
ProcurementRole)和属性(如hasApprovalThreshold),生成带类型标注的RDF三元组,例如:procurement_2024 :hasApprover :zhang_san。 - AI代理想执行“给供应商打款”操作时,TrustGraph 会拦住它,先查这条指令是否符合你设定的“单笔超5万需副总签字”策略,再查这次付款有没有附上验收单——证据链完整才放行。策略本身以SHACL规则形式存在,例如
sh:constraint [ sh:path :paymentAmount ; sh:maxInclusive "50000" ],系统实时校验数据实例是否满足约束。 - 它不靠猜词义,而是用W3C标准的OWL本体语言定义业务概念。比如“合同编号”和“订单号”明明是两个字段,在普通搜索里永远混在一起,但在TrustGraph里它们从一开始就被标成不同实体类型。本体中明确声明
:ContractNumber a owl:DatatypeProperty,而:OrderID rdfs:subPropertyOf :Identifier,检索时按类型隔离,互不干扰。 - 所有决策都自带溯源:哪条政策、哪份原始文件、哪个版本的本体模型参与了这次判断,全留痕可查。审计时不用再翻聊天记录或Excel表格,直接导出PROV-O格式报告。每条决策三元组都附带
prov:wasGeneratedBy和prov:used指向对应策略URI与文档哈希值。 - 支持把现有系统数据(如ERP里的供应商库、HR系统的组织架构)一键导入,自动映射成图谱节点,不用重写API或清洗字段,文档里明确写了“Docker部署后,5分钟内连通PostgreSQL”。配置界面提供字段拖拽映射器,将数据库表列拖到本体类属性上,保存即生效。
- 你不用自己写本体,项目提供了医疗、金融、政务领域的标准本体模板,选一个,填几处业务字段,就能跑起来。官方示例里有个“医保报销规则图谱”,从加载到验证只用了两页配置。模板存放在
./ontologies/healthcare/insurance-rules.ttl,含27个预置类和41个约束规则,覆盖起付线、封顶线、目录匹配等场景。
上手只要三步
- 打开官网 trustgraph.ai,点页面右上角的「Self-Host」链接,跳转到 config-ui.demo.trustgraph.ai , 这是它的可视化配置后台,不用装任何客户端;该页面由 React 构建,所有操作均通过 HTTP API 与后端交互,无本地计算负担。
- 在后台点「Deploy」按钮,它会自动生成一段 Docker 命令,复制粘贴到你的 Linux 终端里回车,整个平台就跑起来了;命令形如
docker run -d --name trustgraph -p 8080:8080 -v $(pwd)/data:/app/data trustgraph/trustgraph:latest,镜像体积约420MB,启动后自动初始化PostgreSQL和Redis容器。 - 回到浏览器,用默认账号 admin/admin 登录,上传你的第一份制度文档,选预置的金融本体模板,点击「Build Graph」,三分钟内,你的语义图谱就生成好了。系统会在后台调用内置的NLP模块分句、命名实体识别,并绑定到本体类,最终在图形界面中以可缩放节点图呈现“审批流”“责任矩阵”等子图。
项目信息
The Semantic Agent Governance Platform