别再找人做「公司数字足迹扫描」了——这种服务动辄上千块,其实你用一条命令就能干。
它不卖账号、不收年费、不锁功能。所有数据都跑在你自己的电脑上,连网络都不用出。
你不是安全工程师,但你得知道:客户搜你公司名时,看到的到底是官网,还是三年前泄露的测试后台链接?

它替你省掉了什么

它替代的是「商业 OSINT(开源情报)扫描服务」——比如类似 SecurityTrails、Spyse 或国内某些「企业风险监测平台」的入门档位。
你查的不是黑客工具,是自己公司的公开底牌
这类服务通常按月收费,基础版 300–800 元/月,要查邮箱、子域名、JS 文件里的接口,就得加购模块。Photon 把这些全包进一个命令里,价格直接砍到零。
它不替代专业渗透测试,但能帮你提前发现:哪张旧截图还挂在 GitHub 上、哪个离职员工的微博号没解绑公司邮箱、哪份 PDF 里埋着没删干净的内网地址,这些全是付费报告里最常出现的前三项问题。
商业平台返回的结果往往经过聚合压缩,只给结论不给原始来源。而 Photon 每条数据都附带出处:这个邮箱是从哪段 JS 里抽出来的,那个 S3 桶名是在哪张 HTML 的注释里找到的,一目了然。
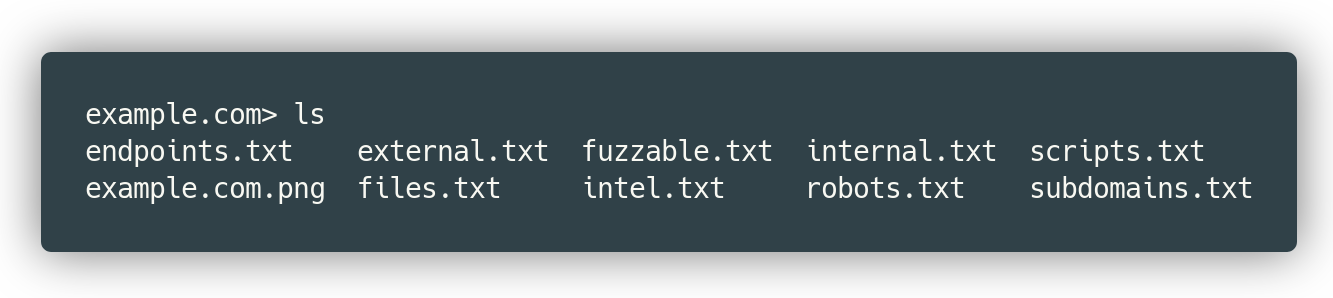
你不需要懂正则表达式,也能看懂结果。生成的文件夹结构清晰:urls/ 目录下分 in-scope 和 out-of-scope,intel/ 下有 emails.txt、socials.txt、buckets.txt,js/ 里存着解析过的脚本内容和提取出的 endpoint 列表。
它能干什么

- 自动翻出目标网站所有带参数的链接,比如
shop.php?id=123或api/v2/user?token=xxx。这类地址往往是未关闭的测试接口或历史遗留入口,商业扫描常漏掉,Photon 会单独归类标出来。 - 从 JS 文件里揪出隐藏的 API 地址和密钥片段。不是只列文件名,而是真去解析内容,把
https://api.xxx.com/v1/login和const KEY = "a1b2c3..."这种字符串直接拎出来存进结果文件。 - 调用 Wayback Machine(archive.org)的快照当种子,不用等爬虫慢慢发现页面,官方明确写了这个功能,能跳过大量死链,直接抓历史有效 URL。
- 扫出邮箱、GitHub 用户名、LinkedIn 主页、Amazon S3 桶名等公开线索。不是模糊匹配,而是按预设规则识别,比如
@company.com结尾的邮箱会被单独归进emails.txt。 - 提取 PDF、PNG、XML 等附件文件,并记录它们的原始 URL 和大小。对法务或合规人员很实用:你知道哪些文档被公开上传过,而不仅是“有文件”。
- 支持自定义正则,比如你想找所有含
password或secret_key的行,改一行配置就能加进去,不用动代码。 - 还能配合 dnsdumpster 插件,自动查询 DNS 记录中的子域名和邮件服务器信息,结果直接合并进主报告,不用手动切窗口比对。
- 导出格式不只是 JSON,也支持 CSV 和 Markdown 表格,方便粘贴进内部周报或审计材料,不用再花时间整理格式。
上手只要三步
- 确认你的电脑是 Linux 系统(官方说明只支持 Linux,macOS 和 Windows 需靠 Docker,但文档没提供一键脚本,建议直接用 Ubuntu 或 Debian 虚拟机);
- 打开终端,粘贴这三行命令:
git clone https://github.com/s0md3v/Photon.gitcd Photonpip3 install -r requirements.txt, 官方说这是最轻量的安装方式; - 运行
python3 photon.py -u example.com --wayback,把 example.com 换成你要查的域名,几秒后结果就生成在本地文件夹里,不用登录、不用注册、不传任何数据到远程服务器。 - 如果想限制爬取深度,加
--depth 2;想避开某些路径,加--exclude "\.git|\.svn";想加快速度又不怕丢数据,加--threads 10, 所有参数都在 Wiki 的 Usage 页面列得清清楚楚。