你是不是也这样?用某付费知识库工具,每次改个PDF、删个Excel,就得手动点「重新上传」再等几分钟索引——中间有人来问,你只能回:“刚改过,还没同步,稍等。”
有些工具连“稍等”都说不出口:它压根没通知机制,你得自己记得去点、去等、去查,一不小心就答错了。
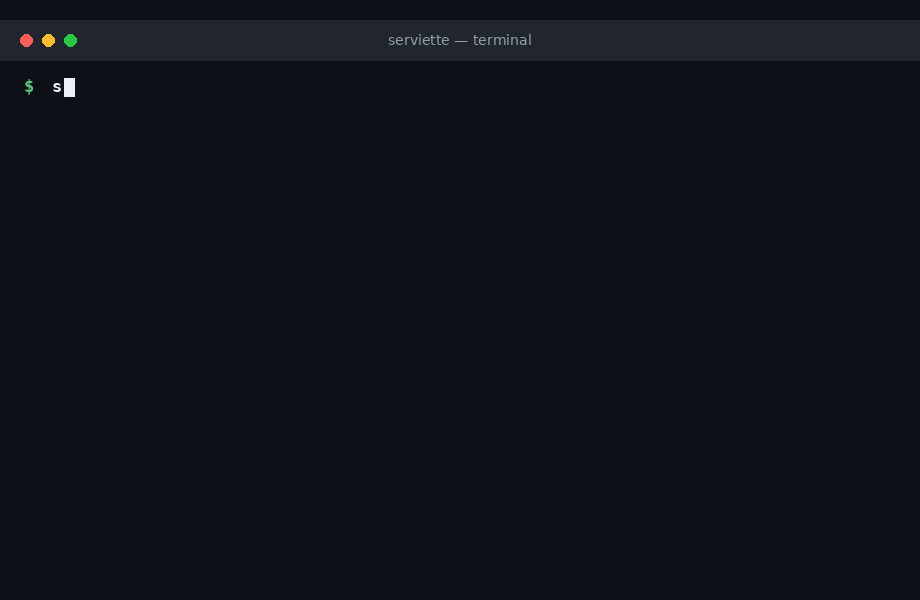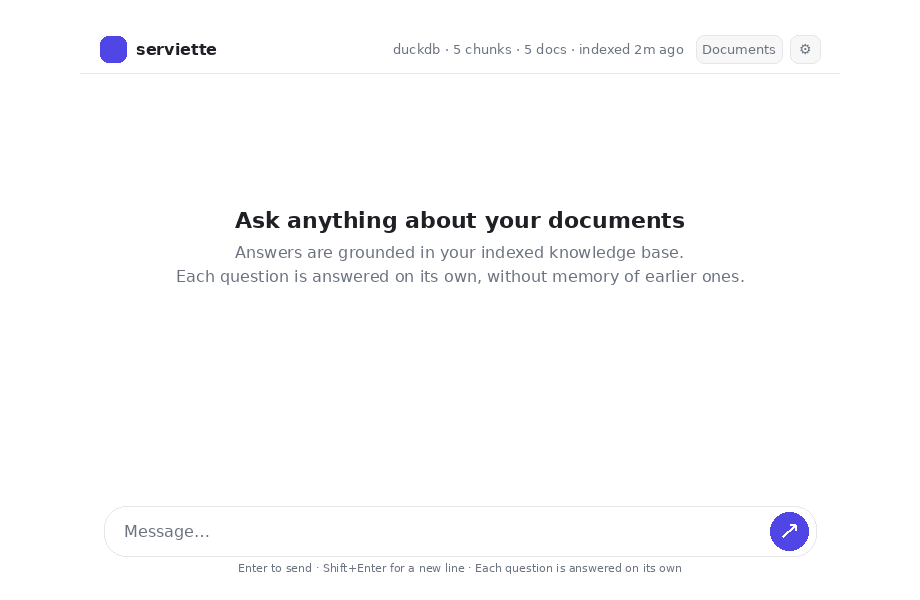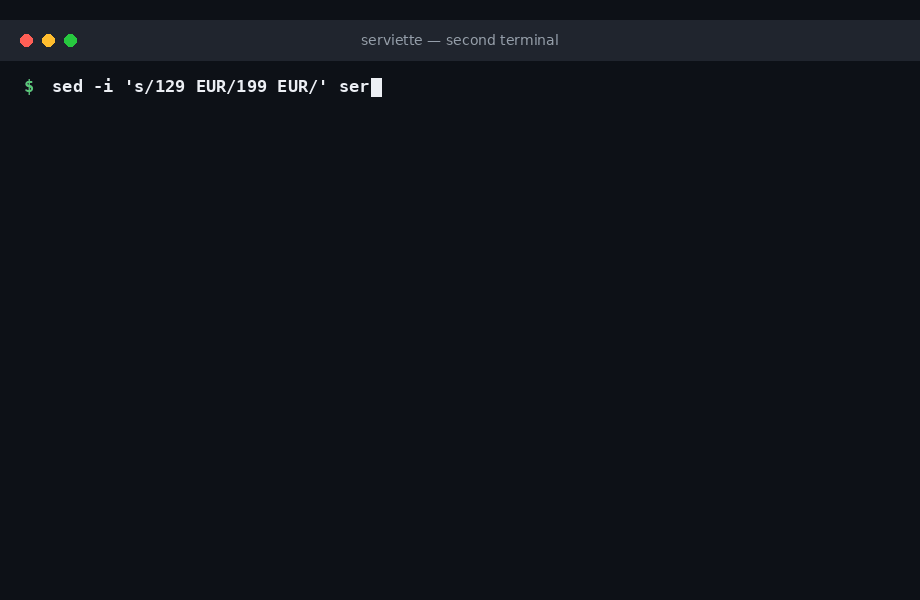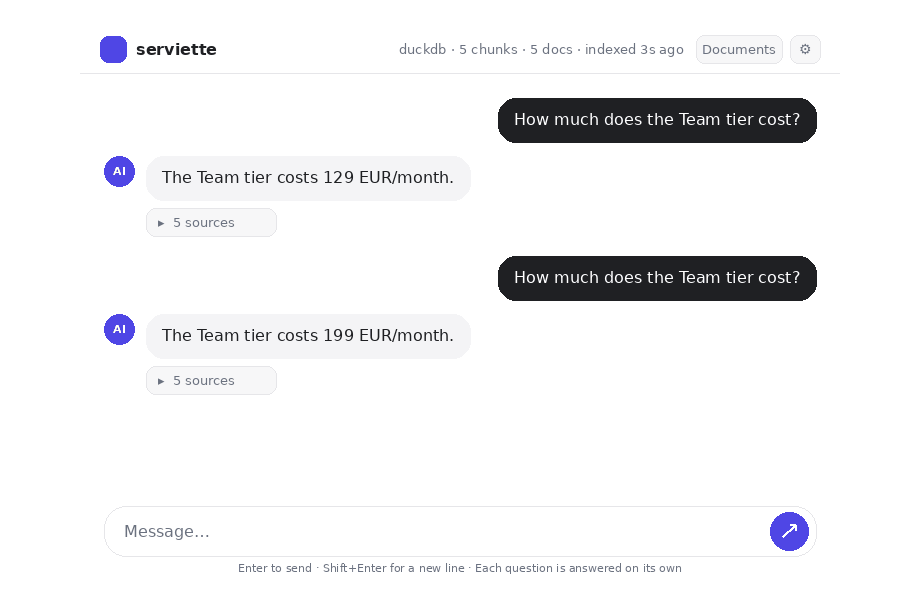
其实,真有东西能做到:你保存文档的瞬间,后台就悄悄更新了答案。不是“稍后同步”,是“秒级生效”。
它不依赖定时扫描,也不靠你手动触发。只要文件系统里那个.md文件被保存,或者新PDF被拖进文件夹,底层引擎立刻捕获变更,重新解析、重新嵌入、重新更新向量索引——整个过程在几秒内完成。
这个“几秒”,是真实响应时间,不是界面轮询间隔。它基于文件系统事件(inotify on Linux, FSEvents on macOS),不是每30秒扫一次目录。
它替你省掉了什么
它不直接对标某个具体收费软件,但干的是三类人正在掏钱干的事:企业用的私有知识库SaaS、咨询公司搭的定制RAG服务、还有个人买的各种AI文档助手会员。
编辑一个文件,答案跟着变,不是“等会儿”,是“现在”。
比如某知名知识库平台,基础版每月30美元起,按文档量或API调用量额外计费;而 serviette 本身完全免费,唯一可能花钱的地方,是你自己选的模型API(比如OpenAI),但只按问题次数扣,不按文档数量收。
价格直接砍到零。
它省掉的不只是钱。你还省掉了「索引状态面板」,那种永远显示“处理中(72%)”的页面;省掉了「上传失败重试」弹窗;省掉了把Word转成PDF再上传的多余步骤;也省掉了每次改完文档后,对着同事说“我刚更新了,你再问一遍试试”的尴尬。
主要能干这几件事
- 把本地文件夹变成可提问的知识库:丢一堆PDF、Word、Markdown进去,不用转格式、不用切段落,serviette 自动解析并建立索引。改完文档保存,几秒内新内容就能被问到。它用的是 Apache Tika 和 unstructured.io 的解析器组合,能正确提取表格、标题层级和列表结构,不是简单扔进OCR。
- 换数据库不用重做:它支持8种向量数据库,从轻量级的SQLite、Chroma,到企业级的PostgreSQL、Milvus。换一个,改一行YAML配置就行,旧数据不用迁移、不用导出导入。配置项叫
vector_db.type,值填sqlite或postgres即可生效。 - 回答带出处,谁都能验证:每次回复下面都附带引用来源,精确到文件名和段落位置。老板问“这结论哪来的”,你直接截图发过去,不用翻半天。引用格式是标准 Markdown 链接,点击能跳转到原始文档对应位置(如果该文件仍存在且可访问)。
- 嵌入计算可全本地:不想把文档发给云端API?用内置的本地embedder(比如all-MiniLM-L6-v2),全文本、embedding、索引全部留在你自己的Linux机器上,不走外网。模型权重通过 Hugging Face Hub 下载,首次运行时自动缓存到
~/.cache/huggingface/transformers。 - 接口干净,前端随便接:自带HTTP REST API,返回标准JSON,前端工程师拿curl试两下就能联调;也自带一个简洁网页聊天界面,开箱即用,不装浏览器插件、不注册账号。API端点是
/v1/chat和/v1/query,请求体是纯文本,响应含answer、citations和retrieved_chunks字段。 - 数据全程不出你的电脑。默认配置下,所有解析、嵌入、索引、检索都在本地进程完成。只有当你显式配置了
llm_provider: openai并提供密钥时,才将召回的片段发送至 OpenAI 接口生成最终回答。
三步上手
- 去官网 免费领一个Pathway许可证(点一下GitHub或LinkedIn登录就行),复制好KEY;这个KEY有效期一年,续期也是点一下。
- 在Linux终端里运行三行命令:pip install serviette → export PATHWAY_LICENSE_KEY=你刚复制的KEY → export OPENAI_API_KEY=你自己的OpenAI密钥(或跳过这步用本地模型);注意第二步必须在当前终端生效,新开窗口要重新设置。
- 最后执行 serviette demo –embedder openai,浏览器打开 http://localhost:8989 就能开始聊,整个过程不需要改任何代码,也不用碰YAML文件。demo 模式会自动生成配置、下载示例文档、启动服务,适合第一次体验。
项目信息
pathwaycom/serviette
GitHub
A no-code RAG server that keeps answers in sync with your documents. Works with 8 vector databases. Built on Pathway.