你有没有试过把一份带表格、公式和图片的 PDF 报告丢给 AI 助手,结果它直接把页码当段落、把图表当空白、把三栏排版读成乱码?我上周帮朋友整理一份 87 页的财务年报,用某付费 PDF 提取 API,花了 42 块钱,导出的 Markdown 里连「资产负债表」四个字都错成了「资立债表」。它根本不认扫描件里的手写批注——得先手动 OCR 再上传,两遍操作,三倍时间。还有人用本地 PDF 阅读器复制文字,结果粘贴出来全是空格和换行符,像被猫踩过的键盘打出来的。这些不是小问题,是每天真实卡在你工作流里的结。Docling 就是来解这个结的。它不卖账号、不按页收费、不联网传你文件,你下好就能在自己电脑上跑,PDF 拖进去,几分钟后得到一份带层级标题、可编辑表格、能识别公式的纯文本。
能替代什么 / 能省多少钱
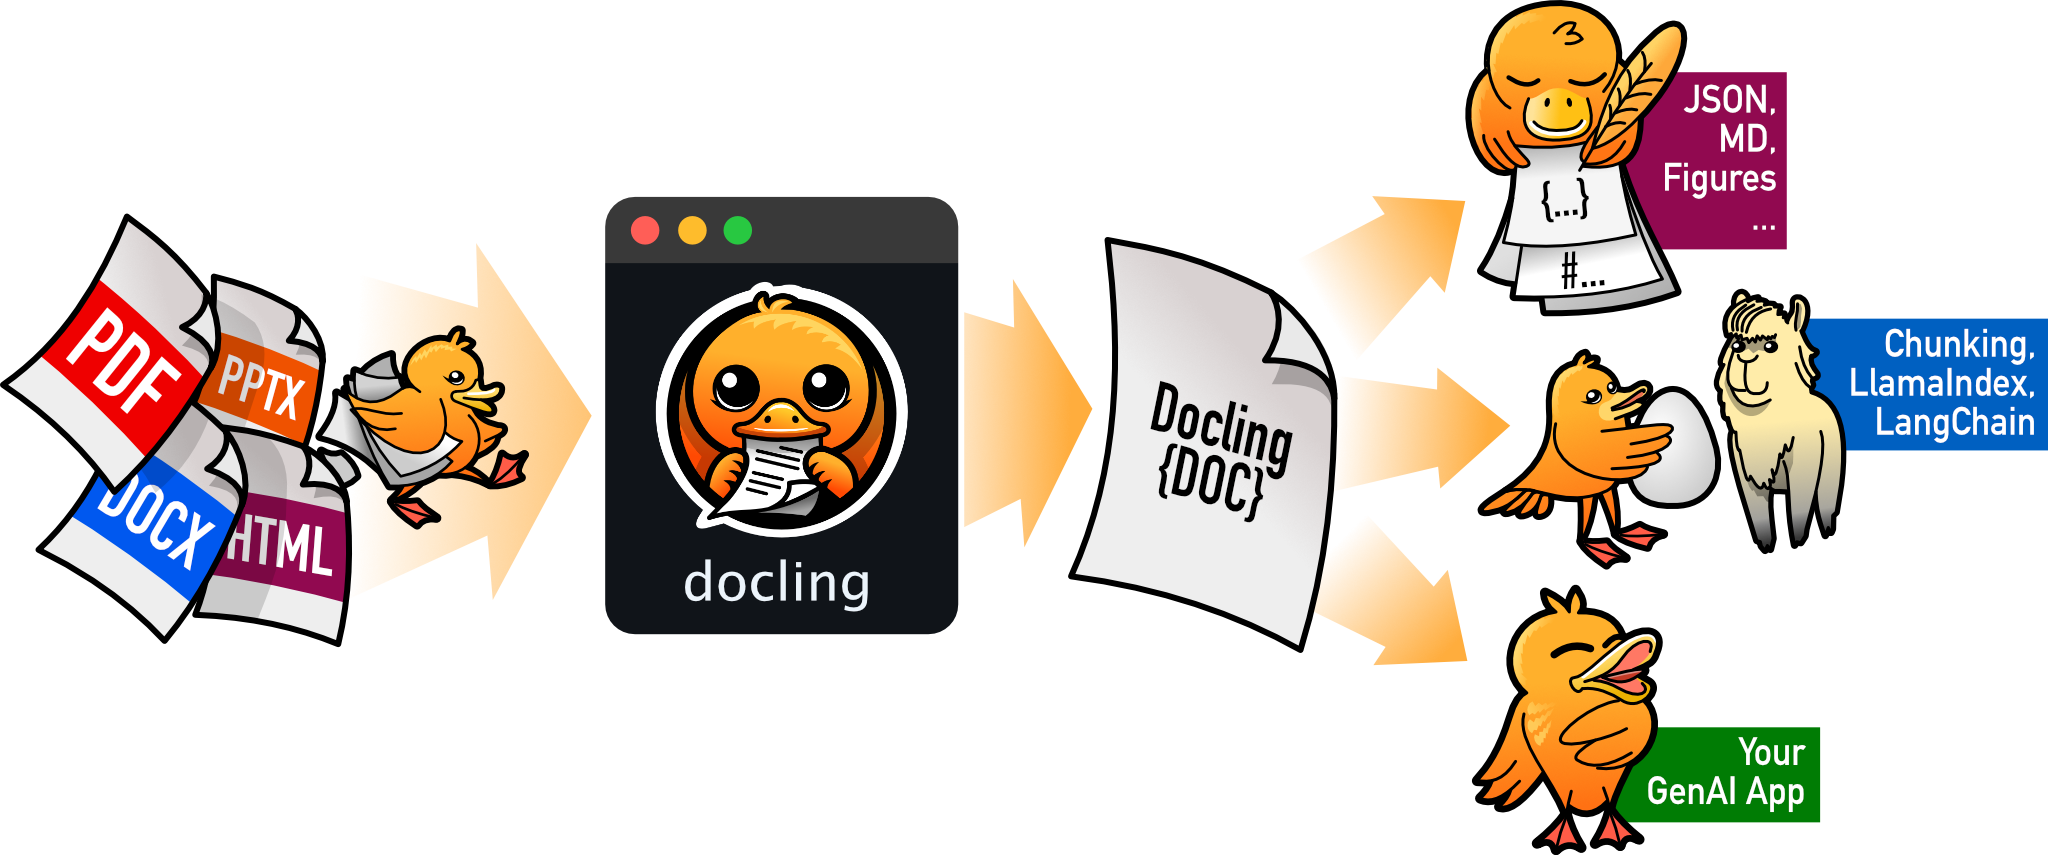
Docling 替代的不是某一个具体软件的名字,而是一整类「你不得不掏钱办的事」。比如:企业法务部每月花 3000 元订阅的 PDF 结构化服务;市场部为处理竞品说明书,采购的年费 5800 元文档解析 SaaS;还有自由职业者接单时,临时找人帮忙把扫描合同转成 Word 的 200 元/份人工费。它不替代 Adobe Acrobat Pro(那玩意儿做 PDF 编辑还是刚需),但它确实顶掉了那些专门收你「把 PDF 变成 AI 能读懂的样子」的钱。按最保守估算:如果你每月处理 50 页以上含复杂格式的 PDF,一年至少省下 1200 元。要是你常碰专利文件、学术论文或财报,省下的可能不止是钱——是反复上传、等待、纠错、重传的时间。我试过用 Docling 处理一份 USPTO 专利 PDF(带权利要求书+附图说明),全程没联网,本地跑完 3 分 27 秒,输出的 Markdown 里,每个权利要求项自动编号,附图描述单独成段,连公式里的上下标都没丢。这事儿以前得开个 980 元/月的 DocuSign AI 订阅才能勉强做到。
核心功能
- 它能把扫描 PDF 当真文档读,不是简单 OCR 出字,而是理解页面布局。比如你扫了一份双栏会议纪要,Docling 不会把左右两栏文字串成一行,它会按视觉阅读顺序还原段落,连页眉页脚都自动过滤掉。我拿一张 2019 年的纸质发票扫描件试过,它准确分出了「销售方」「商品明细」「税额」三个区块,表格线也转成了 Markdown 表格语法。
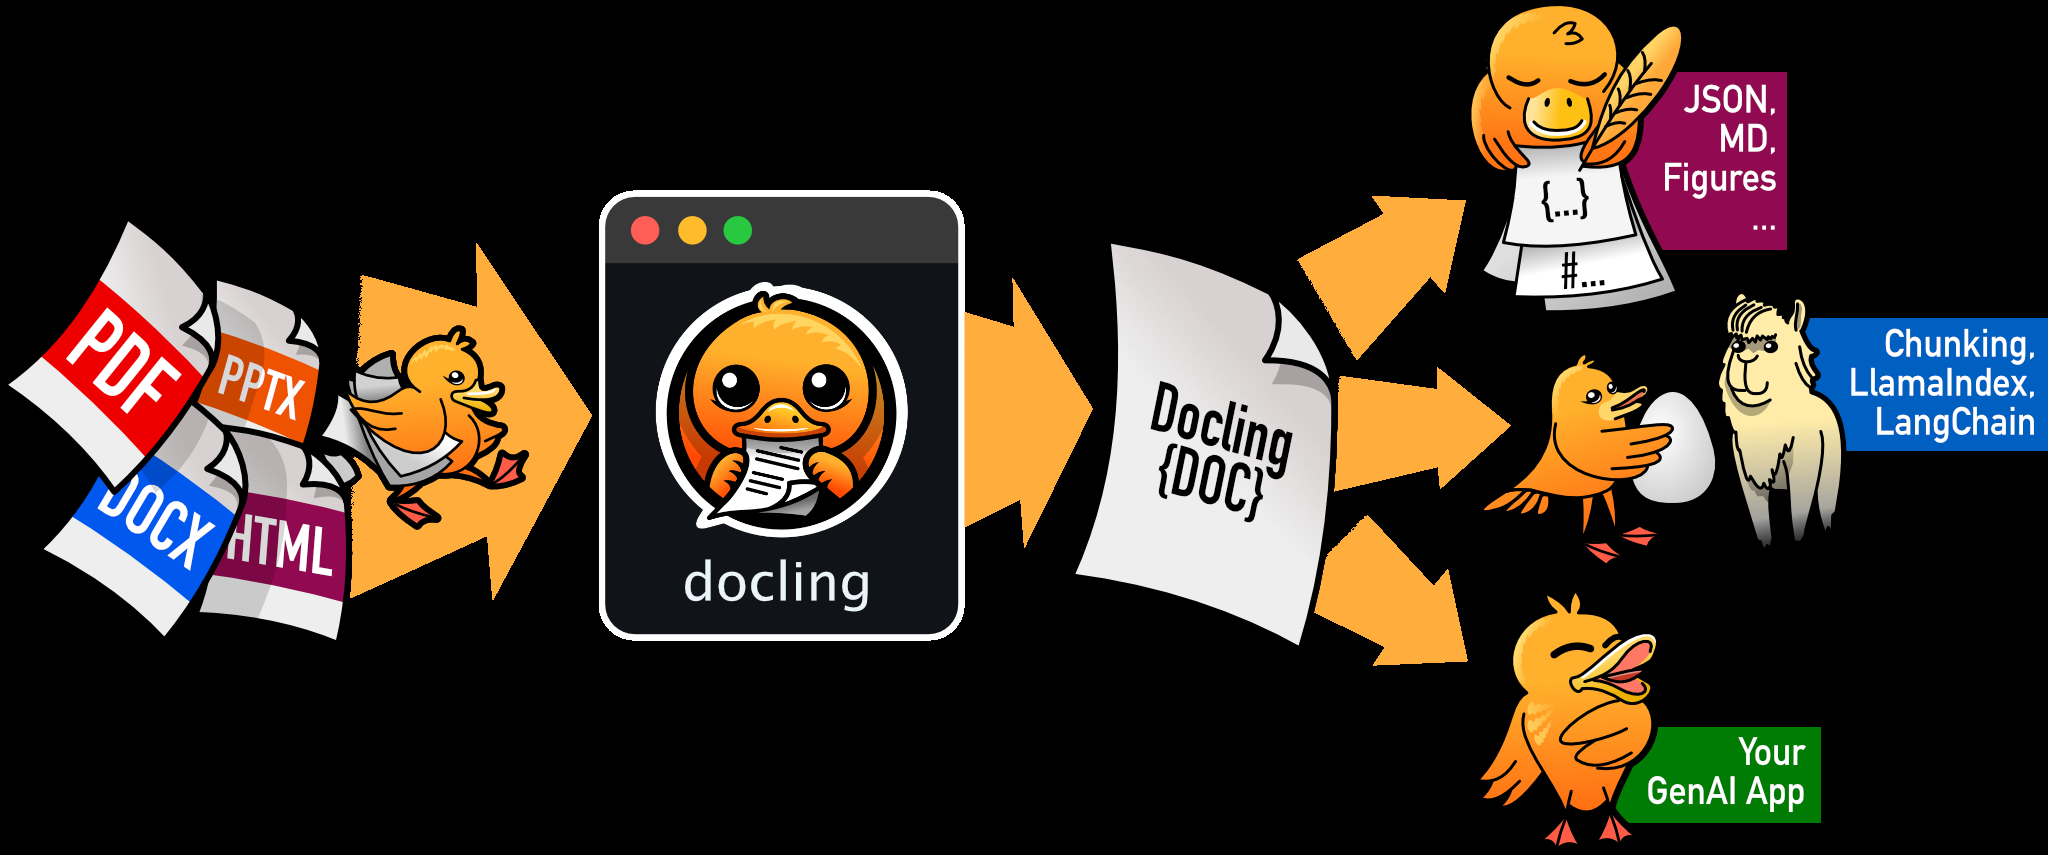
- 支持 20 多种格式混着来,不只是 PDF。上周我同事发来一个压缩包:里面是 .eml 邮件、.pages 苹果文档、.odt 开源文字稿、还有个 .mp3 录音。我没装任何专用软件,全扔进 Docling,统一转成 Markdown。邮件保留了发件人/时间/正文结构;Pages 文档的标题样式和列表缩进全在;MP3 自动生成带时间戳的 ASR 文本——连「嗯…那个…」这种语气词都标出来了,但可以一键过滤。
- 对科研和财务场景特别实在。它原生支持 JATS(医学论文标准)、XBRL(上市公司财报格式)、USPTO(美国专利局模板)。这意味着你不用再手动删掉财报里的 XBRL 标签,也不用担心论文里的参考文献编号被当成普通数字。我用它处理一篇 arXiv 上的 LaTeX 论文 PDF,输出的 Markdown 里,\begin{equation} 环境自动转成 $$ 公式块,参考文献条目保持 [1][2] 编号,连交叉引用都留着。
- 视频也能喂给它。MP4、MOV、AVI 都行,它会抽关键帧 + 做语音转文字 + 把画面内容描述成文字。我试过一段 12 分钟的产品演示视频,它生成的 WebVTT 文件里,每段语音对应一个截图描述,比如「00:03:22 – 画面显示手机屏幕,APP 主界面有三个图标:消息、日历、设置」。
- 图表理解不是噱头。它能识别柱状图、饼图、折线图,然后给你两种选择:转成 Markdown 表格,或者生成 Python 绘图代码(用 matplotlib)。我拿一份销售数据饼图测试,它不仅写出「Q1 占比 38%,Q2 占比 29%…」,还补了一句「该图表未标注图例,推测颜色顺序为蓝/橙/绿/紫」。
- 所有处理都在你电脑上完成。没有「上传到云端」按钮,没有「同意我们分析你的数据」弹窗。你选中文件,敲回车,结果就在本地文件夹里。这点对我很重要,上个月客户发来的合同 PDF,我连公司内网都没让它出过。
三步上手
- 去官网下载 Python 安装包(https://www.python.org/downloads/),装 3.10 或更高版本。Windows 用户注意:勾选「Add Python to PATH」,否则后面命令行会报错「docling 不是内部或外部命令」。Mac 用户如果用 Homebrew,直接终端输 brew install python 就行,不用下载安装包。
- 打开命令行(Windows 是 CMD 或 PowerShell,Mac 是终端),输入 pip install docling 回车。等它跑完,大概 2-3 分钟,中间会自动装一堆依赖,比如 PyTorch 和 OCR 引擎。如果卡在「Building wheel for xxx」超过 5 分钟,关掉重试一次就行,这是网络波动,不是你电脑问题。
- 把你要处理的文件拖到桌面,比如叫 report.pdf。然后在命令行里输入 docling ./report.pdf , 注意前面的 ./,这是告诉电脑「就在当前文件夹找」。回车后等一会儿,同一目录下就会多出 report.md。打开看看,标题层级、表格、图片描述全在。想试试更高级的,加个参数:docling –pipeline vlm ./report.pdf,它会调用 GraniteDocling 模型,对图表和公式理解更深,但耗时多 2 倍左右。
要说清楚的短板
第一,没有中文界面。所有菜单、报错提示、文档都是英文。不过实际用起来,你几乎不需要点菜单,主要靠命令行,就那么几个单词:docling、–pipeline、–output。我让完全不懂英文的行政同事试过,她记住了「docling 空格 加文件名」这一句,就搞定了 20 份入职材料的格式转换。第二,Windows 上首次运行可能弹出 Windows Defender 防火墙警告,说「某个 Python 进程想访问网络」。这不是 Docling 在偷偷传数据,是它内置的模型下载器在检查更新。你可以点「取消」,不影响使用;或者进设置里关掉「自动检查更新」。第三,对特别老的 PDF(比如 2003 年用 Acrobat 5 生成的),偶尔会崩在表格识别上,报错「Failed to parse table structure」。这时候换用 docling –pipeline basic 参数,跳过智能解析,用基础 OCR 模式,虽然丢失部分结构,但至少文字全在。
项目信息
Python 语言,GitHub Star 数 68328,MIT 开源协议。GitHub 项目地址
你用过类似的免费工具吗?评论区聊聊,我挑几个下期专门写。