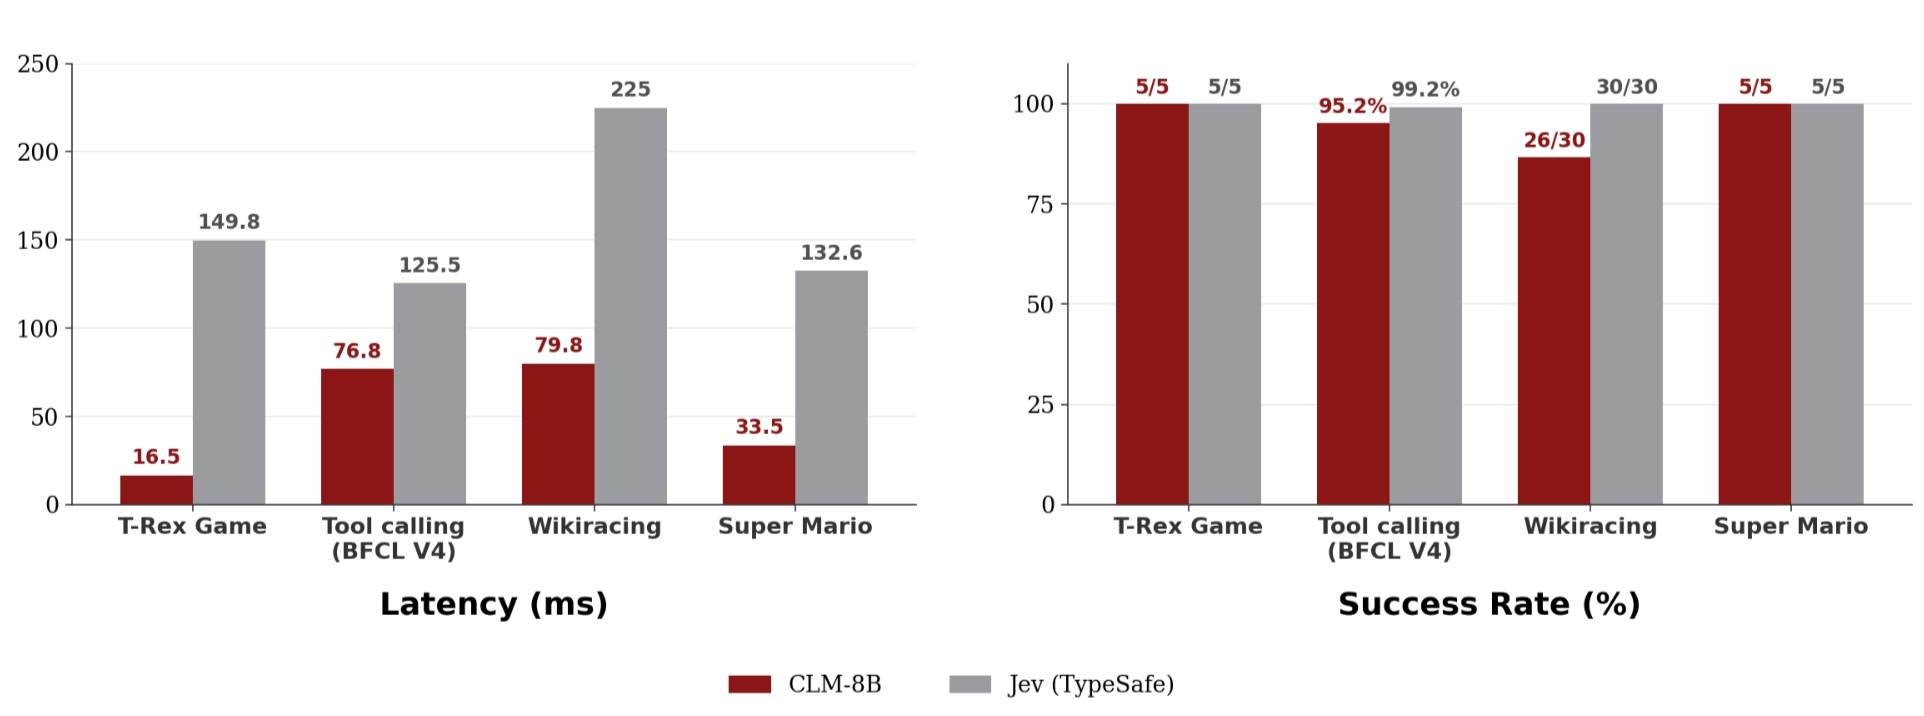
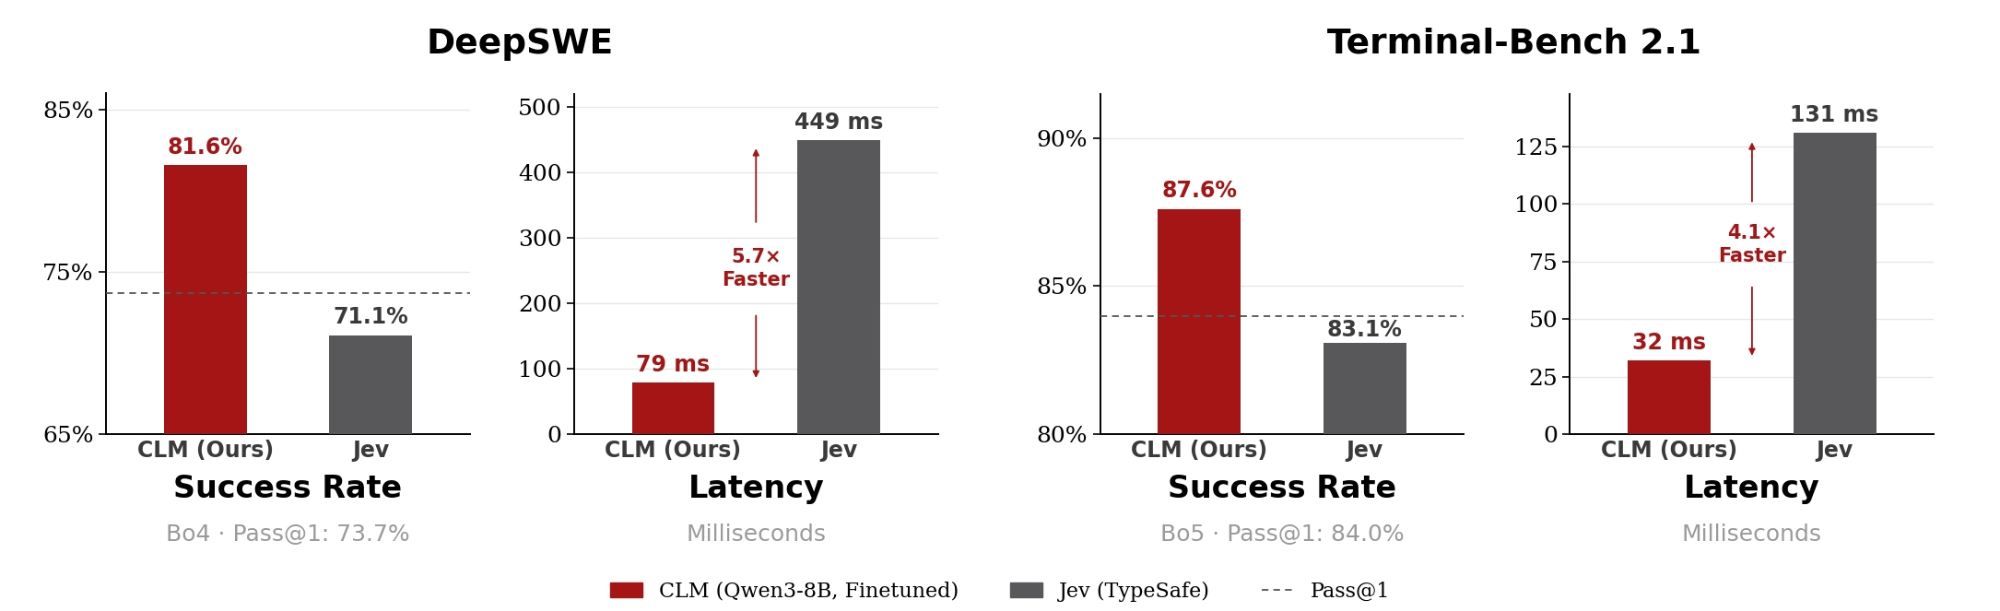
你是否遇到过这样的场景:客服机器人需要从用户一句话中同时判断紧急程度、归属部门、情绪等级;游戏AI需在毫秒内评估多个操作选项的合理性;或者代码助手要在数十个工具调用候选中快速选出最优解?传统大模型逐字生成答案的方式既慢又难控制。Contrastive-LM(CLM)正是为此而生——它不生成长文本,而是以「状态-动作」对比学习范式,将复杂决策拆解为可并行、可缓存、可量化的结构化打分任务,实测延迟比同类模型低至1/9,却在终端交互、工具调用等关键指标上达到业界顶尖水平。
核心功能
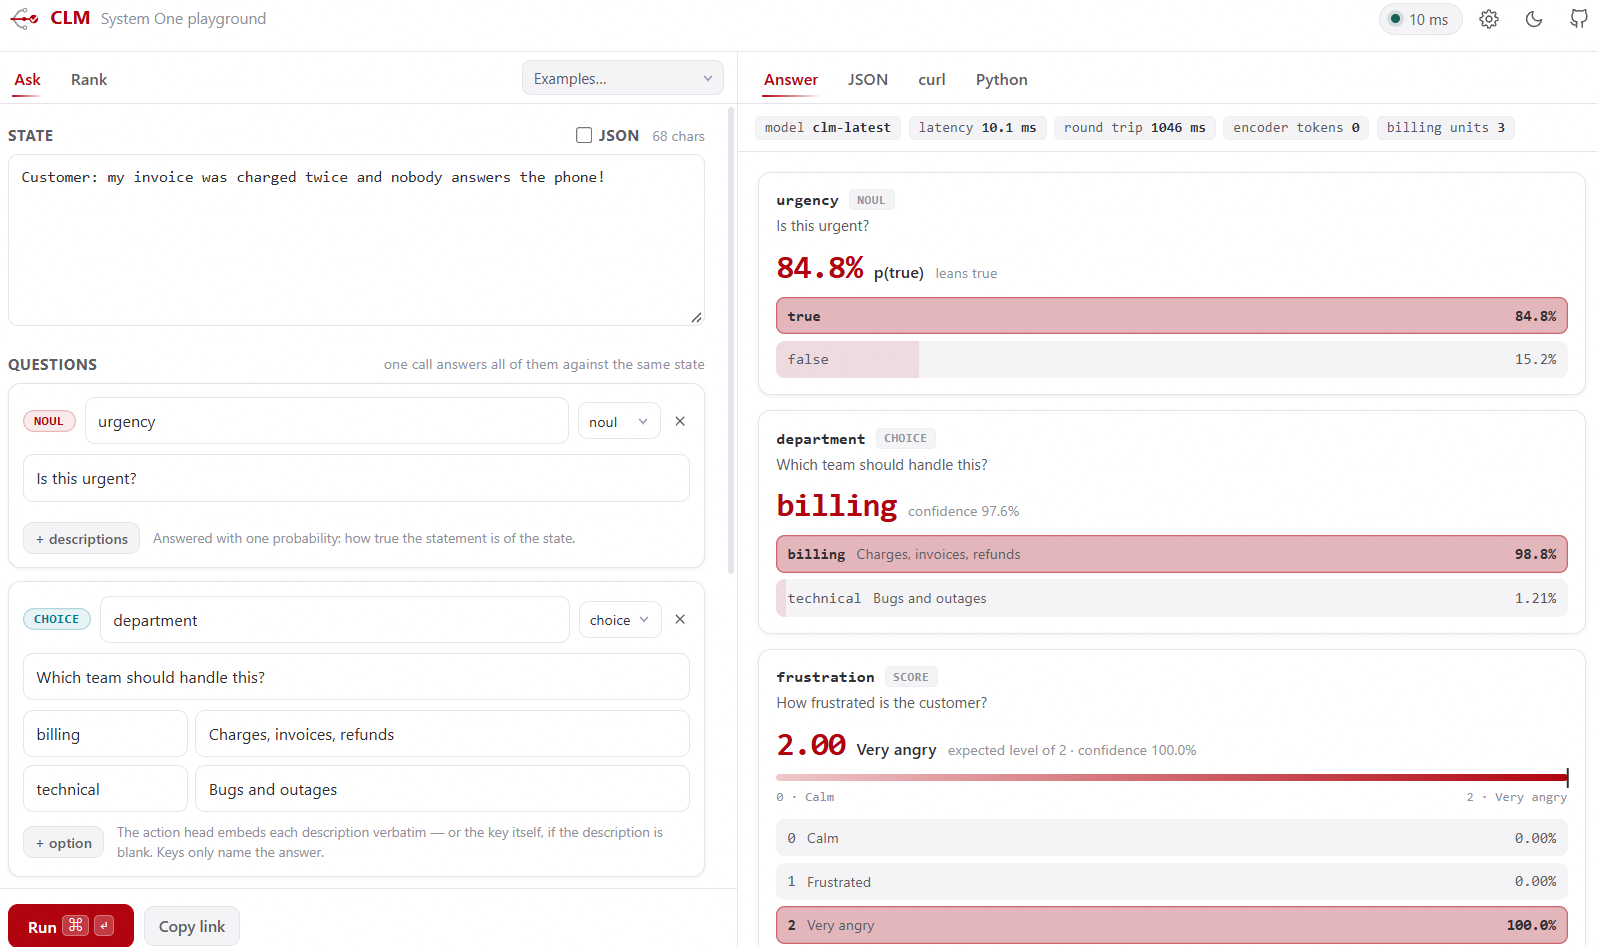
- 多维度结构化问答:支持在同一请求中并发回答「是/否类判断(Noul)」、「多选分类(Choice)」、「连续值评分(Score)」三类问题,例如对一句客户投诉,同步输出「是否紧急(概率0.41)」「应转交部门(billing: 93.8%)」「情绪强度(1.98/2)」,结果天然结构化,无需后处理解析。
- 零样本候选集排序(Ranking):无需微调即可对任意候选列表(如工具名、API参数、游戏动作)进行精准打分排序,返回每个选项的置信度与排名,特别适合Best-of-N生成、工具选择、路径规划等场景。
- 状态与动作嵌入分离缓存:用户输入(state)和问题模板/候选选项(action)的向量分别独立计算并持久化缓存,相同问题模板复用时仅需1次嵌入计算,大幅降低重复请求开销,实测冷启动后二次请求延迟下降70%以上。
- 开箱即用的本地服务化部署:提供
clm-serve一键启动HTTP API服务,自动下载75MB轻量级参考头(reference head),配合vLLM托管Qwen3-8B嵌入模型,单卡3090即可流畅运行,无需依赖Hugging Face推理端点或云服务。 - 内置可视化交互沙盒:访问
http://localhost:8700即可打开Web Playground,实时编辑状态文本、添加结构化问题、查看概率分布直方图、复制curl/Python调用代码,所有请求自动生成可分享链接,极大提升调试与演示效率。 - TypeSafe兼容接口设计:Python SDK严格遵循类型提示(
Noul/Choice/Score类),参数结构与JSON wire format完全一致,确保本地测试代码可无缝迁移到生产HTTP服务,杜绝字段命名不一致导致的集成故障。 - 轻量级微调适配器:官方提供在Terminal-Bench 2.1(87.6% SOTA)和DeepSWE(81.6%)等代理编码基准上的微调教程,仅需1M轨迹数据即可显著提升验证器能力,远低于主流RLHF方案所需的数据量。
技术亮点
- 真正的「System One」架构:区别于传统「System Two」推理模型(如思维链CoT),CLM将决策建模为状态(state)与动作(action)的对比学习任务,通过60M真实Q&A对预训练 + 30M合成难负例中训 + 1M智能体轨迹后训,使模型学会直接映射「当前情境」到「最优结构化响应」,跳过冗长文本生成环节。
- 双模型协同服务栈:采用「嵌入模型(Qwen3-8B)+ CLM轻量头」解耦设计。vLLM托管的嵌入模型专注高效计算token向量,CLM头仅负责对比打分,二者通过HTTP API通信,既保证语义理解深度,又实现头部模型极小化(75MB),GPU显存占用比全量LLM低一个数量级。
- Token级缓存优化机制:对问题模板中的指令文本(如
"Is this urgent?")和选项描述(如"Charges, invoices, refunds")进行一次性嵌入并缓存,后续请求仅需计算动态state部分,使106-token请求的实际计算量压缩至38 token,成为高并发Agent服务的理想底座。 - 原生支持长上下文扩展:通过同步调整
vllm serve --max-model-len与clm-serve --max-tokens参数,可将状态长度从默认2048扩展至8192,且因缓存机制,扩展成本远低于全量模型,满足法律合同分析、长日志诊断等场景需求。
适合哪些人用
CLM不是给普通用户写故事的玩具,而是面向构建「可信赖智能体」的技术团队的生产力引擎:
- 客服/工单系统开发者:某SaaS企业将CLM集成进工单路由模块,输入用户邮件原文,50ms内输出「紧急等级(0–3)」「责任团队(5个选项)」「预期解决时长(小时)」三元组,准确率较规则引擎提升42%,人工复核率下降68%。
- 游戏AI工程师:在开放世界RPG中,NPC需实时评估「攻击/对话/逃跑/拾取」四个动作的合理性。CLM将游戏帧状态编码为text prompt,对候选动作打分,替代了原先耗时120ms的Llama-3-70B生成方案,帧率稳定性提升3倍。
快速上手
仅需两步,3分钟启动本地服务:
- 安装客户端:
pip install contrastive-lm - 启动服务:
## 启动嵌入服务(需GPU)
vllm serve Qwen/Qwen3-8B --served-model-name qwen3-8b --runner pooling --max-model-len 2048 --port 8090 &

## 启动CLM API(自动下载head)
clm-serve
- Python调用示例:
from clm import CLMClient, Choice
client = CLMClient()
r = client.system_one(
    state="用户反馈App闪退,iOS 17.5,复现步骤:打开相册→点击分享→崩溃",
    questions={
        "os": Choice(instructions="操作系统类型?", criteria={"ios": "iOS设备", "android": "安卓设备"}),
        "severity": Choice(instructions="崩溃严重性?", criteria={"crash": "立即崩溃", "freeze": "界面冻结", "error": "报错但可继续"})
    }
)
print(r.answers["os"].choice)      # "ios"
print(r.answers["severity"].choice) # "crash"
同类对比 / 注意事项
- vs 通用大模型(Llama/Gemma):CLM不追求通用文本生成能力,但结构化决策速度是其9倍,且输出确定性强(无幻觉)、格式稳定(无需正则提取),更适合嵌入Agent工作流。
- vs 专用分类模型(BERT/DeBERTa):CLM支持跨领域零样本迁移,同一模型可处理客服、游戏、编程等不同场景的结构化问题,无需为每个任务单独训练模型。
- 注意事项:首次运行
clm-serve会自动下载75MB reference head(需联网);若使用非默认端口,需通过CLM_BASE_URL环境变量指定;长文本状态需同步扩大vLLM与CLM的max-length参数,否则触发静默截断。
项目信息
⭐
2.0k
2.0k
Stars
🔀
176
Forks
176
Forks
Python
📄
Apache-2.0
Apache-2.0
编程语言:Python|GitHub Star 数:1986|开源协议:Apache-2.0|GitHub 项目地址
如果你正在构建需要「快、准、稳」结构化决策能力的智能体,CLM不是另一个大模型玩具,而是经过终端交互、工具调用、编码验证三大硬核场景锤炼的生产级决策引擎——它让AI真正学会像人类一样,一眼看穿问题本质,而不是滔滔不绝地猜答案。