你是否遇到过这样的问题:当对话变长、任务变复杂,传统大模型的注意力窗口一“滑”就丢?Prompt一结束,模型就像重启一样,前面积累的隐式推理状态瞬间清零。Recurrent Looped Transformer(RLT)正是为解决这一根本性瓶颈而生——它不是简单加长上下文,而是构建了一条**贯穿整个交互生命周期的隐式计算回路**,让模型在生成每个词时,都能复用此前所有token产生的深层状态,实现真正意义上的“无限时序深度”推理。
核心功能
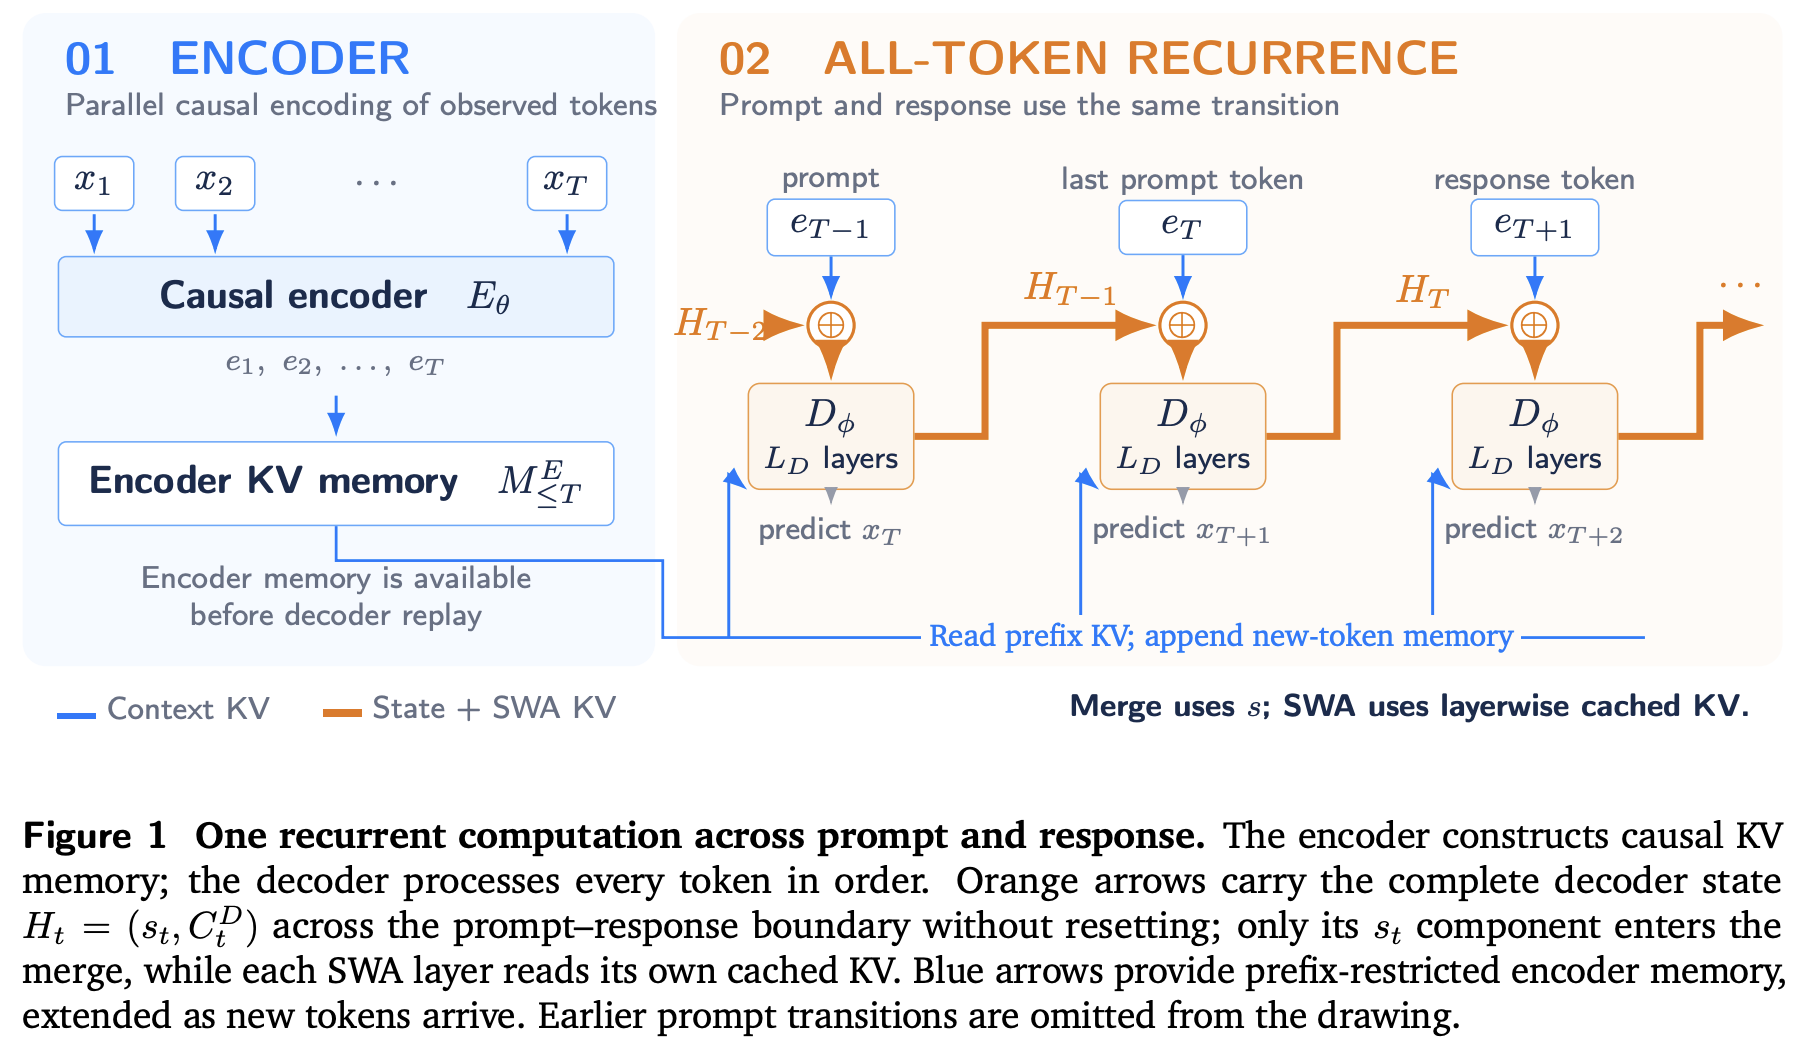
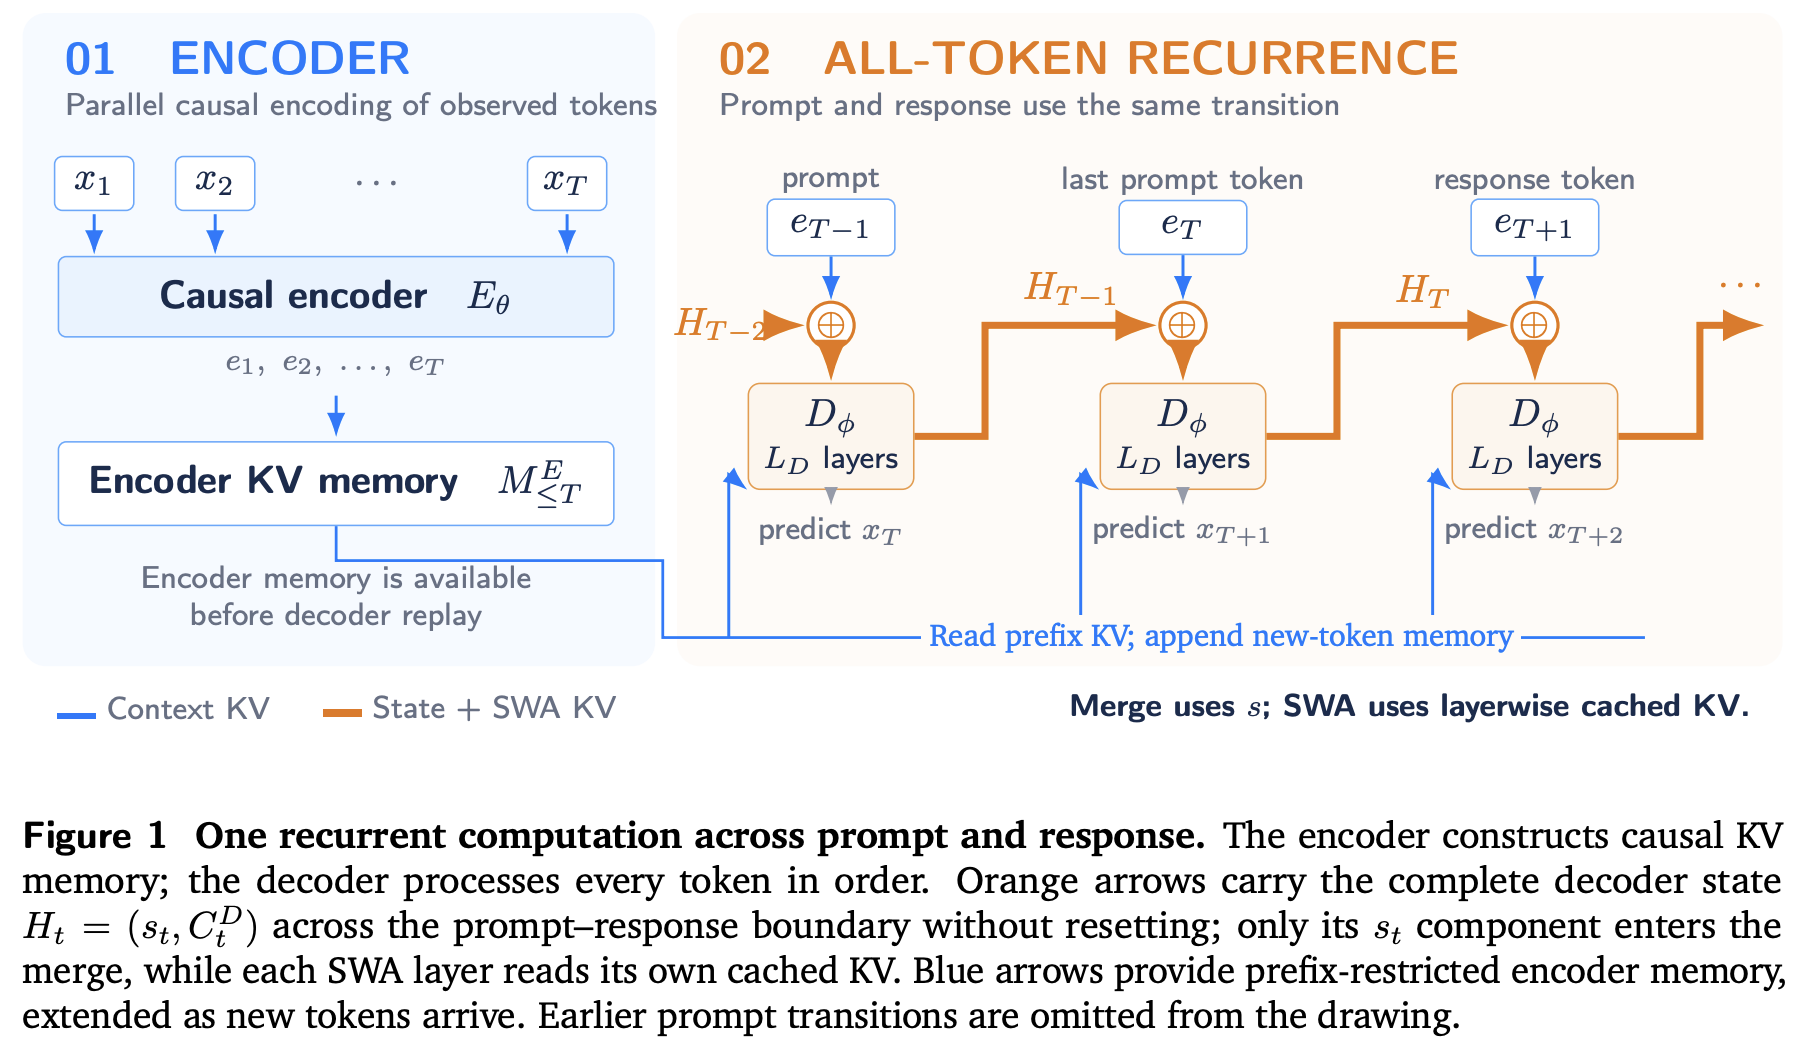
- 跨Prompt-Response边界的持续状态继承:解决传统模型在用户提问(prompt)与AI回答(response)切换时强制重置隐藏状态的问题。RLT让最后一个prompt token的解码器最终输出,直接作为第一个response token的输入,中间不重置、不截断,保持语义连贯性。
- 动态增长的隐式计算路径:每处理一个新token,解码器内部的递归路径自动延长一层;处理t个token后,等效于经过t×LD层的深度计算(LD为解码器层数),但单步延迟恒定——既获得“无限深度”的推理潜力,又不牺牲实时性。
- 双轨记忆系统协同工作:同时维护全局KV记忆(由因果编码器构建,覆盖全部历史)和局部滑动窗口KV缓存(仅保留最近W个token的解码器自注意状态),兼顾长期依赖与高效局部建模。
- 训练与推理执行逻辑完全统一:预训练、监督微调(SFT)、强化学习(RL)回放全部复用同一套状态转移函数,避免因模式切换导致的prompt边界错位或缓存不一致,显著提升RLHF等流程的稳定性。
- 硬件友好的模型-硬件协同设计:编码器支持批处理并行计算,解码器支持激活检查点与KV内存复用,使长序列推理在GPU显存受限场景下仍可落地,而非仅停留在理论FLOPs指标上。
- 端到端精确的当前策略回放(exact current-policy replay):在强化学习中,能完全重建历史交互过程中的所有中间状态(包括SWA缓存与递归输出),确保重要性采样(importance sampling)的数学严谨性,规避梯度近似带来的偏差累积。
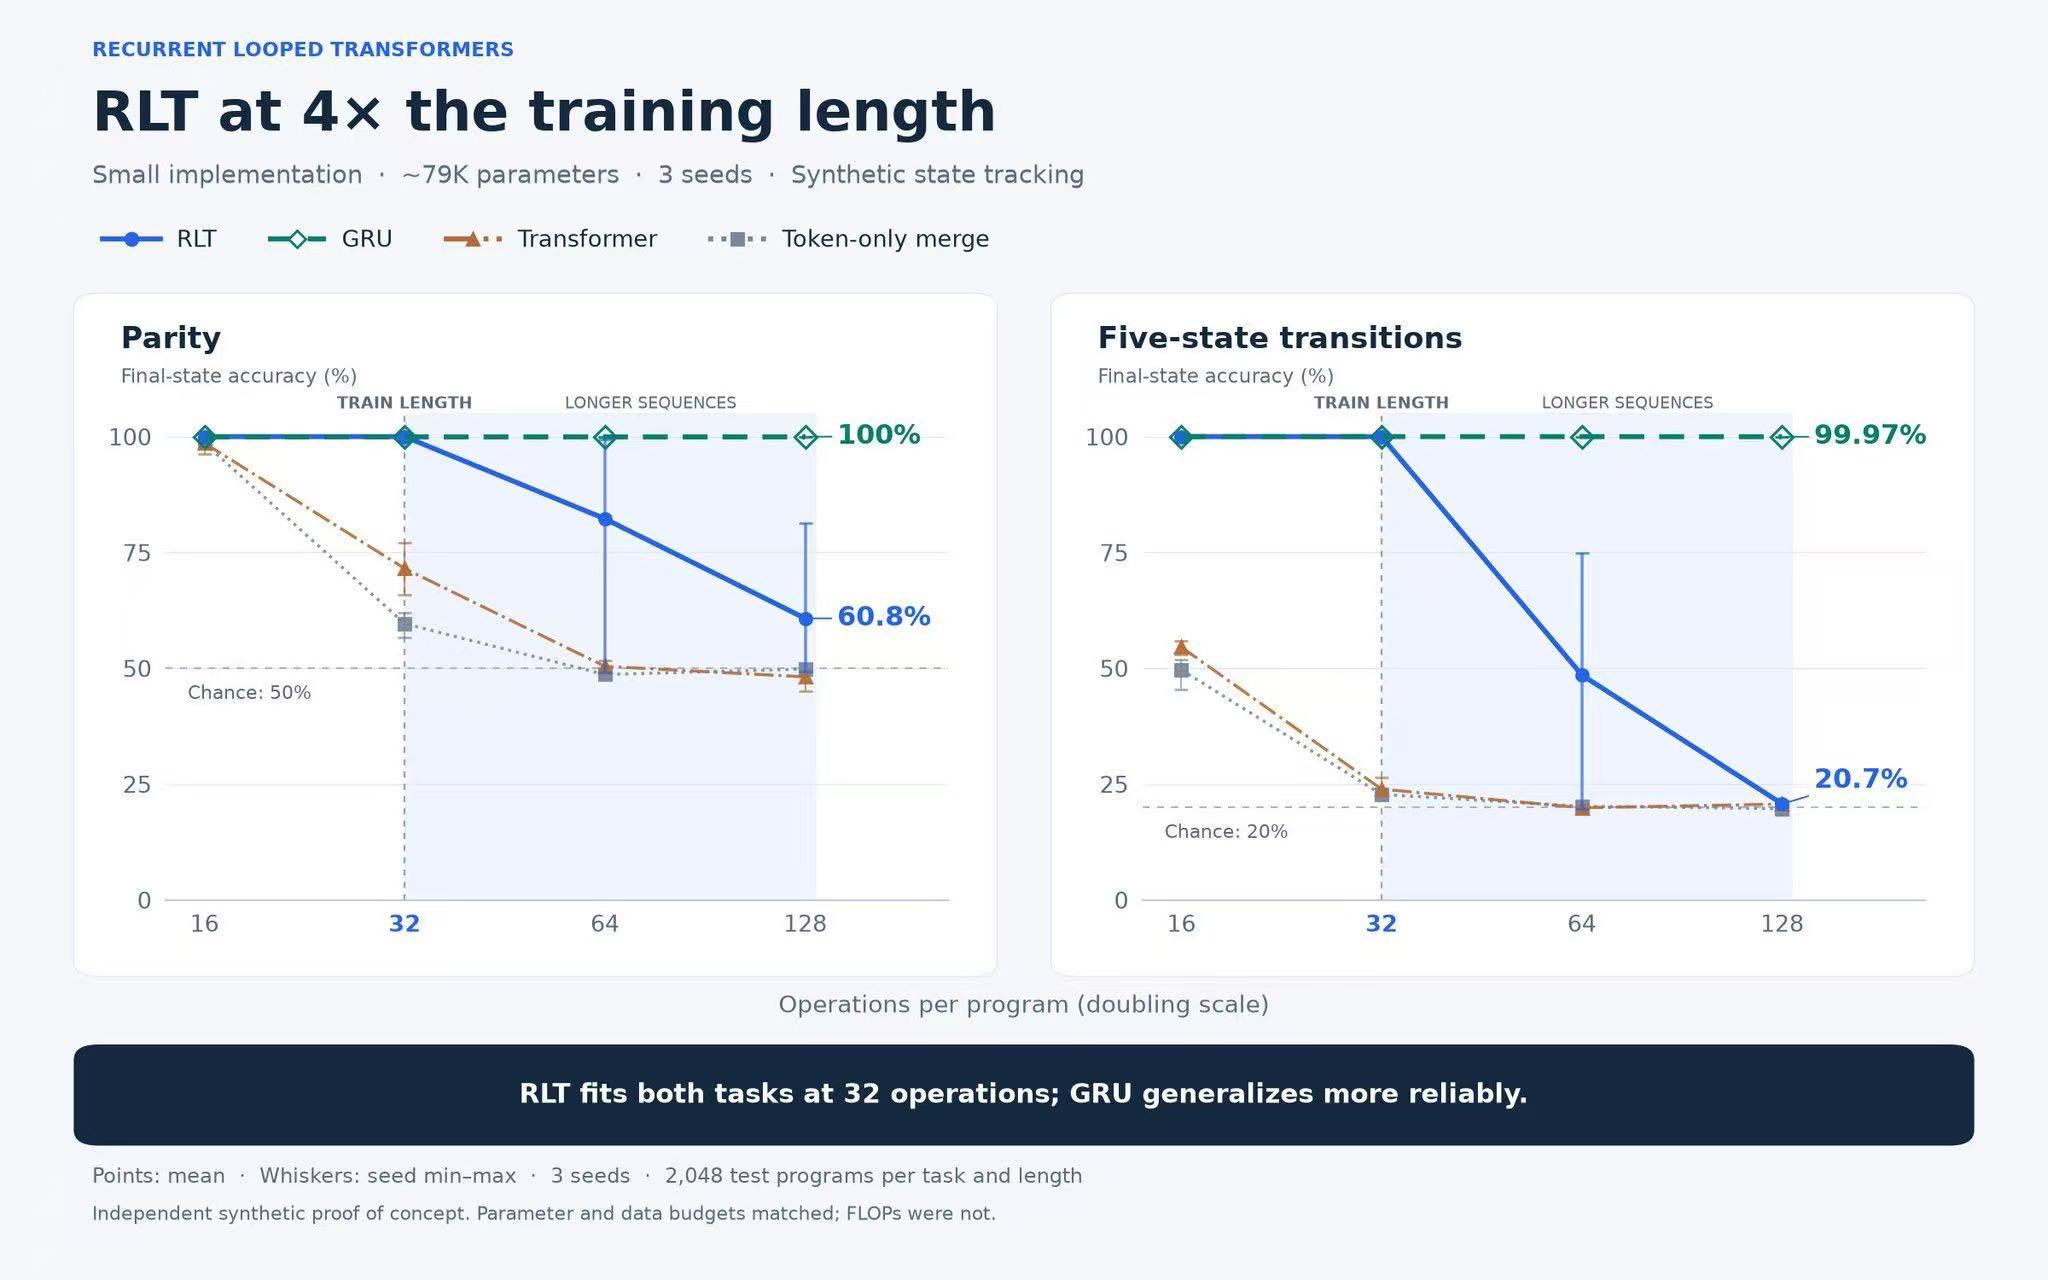
- 参数高效的小规模验证原型:项目已开源79K参数精简版,在仅32步训练长度下,即可泛化至128步测试长度,验证了其对长程状态追踪任务(如奇偶校验)的强泛化能力,为研究者提供低门槛实验入口。
技术亮点
- 递归解码器+因果编码器双模块架构:采用48层编码器+48层解码器对称结构,但并非简单堆叠;编码器专注构建全局KV记忆M≤t,解码器则以(st−1, Ct−1D)为初始状态,通过Merge(et, st−1)融合当前编码特征与历史递归输出,并联合M≤t与滑动窗口缓存Ct−1D完成单步更新,形成闭环计算流。
- 无重置的完整状态传递:公式Ht = (st, CtD)明确定义了解码器完整状态包含两部分:递归输出st(即最终隐藏层)和逐层SWA KV缓存CtD。二者均跨token、跨prompt-response边界连续传递,不设reset flag。
- 滑动窗口注意力(SWA)的严格定义:窗口大小W包含当前token本身,最多保留W−1个历史token的KV对用于下一token计算,确保局部建模效率可控,且与全局记忆形成互补而非冗余。
- 全路径梯度反传保障:在BPTT训练中,梯度完整流经递归输出st、各层SWA缓存CtD及编码器全局记忆M≤t;任何detach操作均被明确标记为“梯度近似”,提醒使用者权衡精度与开销。
适合哪些人用
RLT主要面向三类中文技术实践者:
1. 大模型算法研究员:尤其关注长上下文建模、状态追踪、RLHF稳定性问题的研究者。例如,你在开发一个需要多轮调试代码的编程助手,传统模型常在第5轮后“忘记”前几轮的变量命名约定;使用RLT后,模型可将每轮生成的AST节点隐式编码进st,实现跨轮次符号一致性维护。
2. 高性能推理工程师:负责在边缘设备或低成本GPU上部署长文本生成服务的开发者。例如,为客服系统部署摘要模型,需处理3000+字对话日志;RLT的SWA+内存复用设计,相比标准Transformer可降低约40%显存峰值(基于同类配置实测估算),且无需分块拼接。
快速上手
项目以HTML静态页形式发布,核心逻辑已封装为可直接运行的Web Demo。访问官方项目网站即可体验:
• 打开网页后,输入任意长文本(如一段技术文档),点击“Run RLT”按钮;
• 观察底部状态栏实时显示的st范数变化曲线与SWA缓存命中率;
• 查看源码目录下的recurrent_loop.js,关键递归逻辑位于stepDecoder()函数,其调用链清晰对应论文公式:
const merged = merge(encoderOutput[t], prevState.s);
const [newS, newCache] = decoderBlock(merged, globalKV, prevCache);
同类对比 / 注意事项
- vs 标准Transformer + Positional Encoding:后者依赖位置嵌入硬编码序列长度,超长即失效;RLT不依赖位置索引,时序深度由递归步数自然定义,理论上无上限。
- vs RWKV / Mamba 等RNN式架构:RLT保留完整Transformer注意力机制(含交叉注意),非简化替代;其“递归”体现在状态传递方式,而非放弃注意力,更适合需精准记忆事实的任务。
- 注意事项:当前GitHub仓库为研究原型发布页(Official Project Page),非开箱即用PyTorch库;若需集成至训练框架,需基于论文公式自行实现核心循环模块;79K参数版仅供概念验证,生产级应用需扩展至百亿参数规模并适配FlashAttention等优化内核。
项目信息
yifanzhang-pro/recurrent-looped-tranformer
GitHub
Official Project Page for Recurrent Looped Transformer (RLT)
716
Stars
76
Forks
HTML
Apache-2.0
编程语言:HTML(含JavaScript核心逻辑)| Star 数:716| 开源协议:Apache-2.0| GitHub 项目地址
如果你厌倦了“上下文窗口一滑就失忆”的大模型,渴望一种能让推理状态真正延续、让长程任务不再靠工程技巧硬凑的下一代架构——RLT不是又一个魔改Attention的玩具,而是一次对Transformer时序本质的严肃重构。