你有没有过这种时候:想抓点公开的电商价格、招聘岗位或者新闻标题,结果卡在写 Python、装 Selenium、配 ChromeDriver 上?
不是报错说「找不到元素」,就是页面加载完 JS 才渲染,手动点开调试器看半天,最后放弃——其实要的只是几行数据。
更常见的是:老板说「明天早上要一份竞品新品列表」,你打开 IDE,复制粘贴改 selector,改完发现对方加了反爬,又得熬夜补代理池和 Cookie 管理……
再比如,临时要导出某论坛近三个月的帖子标题和发布时间,但论坛用 Vue 渲染,翻页靠 AJAX,你查了半天 fetch 请求结构,又得模拟 Referer 和 User-Agent,最后发现登录态还依赖 localStorage 里的 token。
这些事本身不难,但每次都要重搭环境、重写逻辑、重调参数。时间花在重复劳动上,而不是真正需要的数据上。

它替你省掉了什么

它不替代某款具体收费软件,但直接绕开了三类常见付费需求:定制爬虫外包(单次 3000–8000 元)、SaaS 爬虫平台年费(主流服务约 2000–6000 元/年)、以及为应付临时需求而买的云服务器+人工运维成本。
你不用再写一行代码,也能让爬虫按时跑起来。
对小团队或个体运营者来说,这不是「少花几百块」的问题,而是把原本需要找人、等排期、反复调试的活,变成自己花 20 分钟画张流程图就能上线的事。
价格直接砍到零。
所有配置都存成 JSON 流程文件,可版本管理、可备份、可复用。今天做的招聘网站爬虫,下周稍作修改就能跑在另一个岗位平台。
它能干什么

- 不用懂 XPath 或正则,也能精准提取网页内容。界面上点选元素,系统自动生成选择器;支持混搭用 CSS、JSONPath 和正则,比如先用 CSS 定位商品区块,再用正则从价格文本里抠出数字。提取失败时,还能直接在 Debug 面板里查看原始 HTML 和每一步输出结果。
- 动态页面照爬不误。集成 Selenium 插件后,自动启动浏览器模拟点击、滚动、等待 AJAX 加载完成,连「下拉刷新加载更多」这类交互都能配置成流程节点。你只需在节点里填入「等待元素出现」的 CSS 选择器,或设置固定等待毫秒数。
- 数据不用手动导出。爬完自动存进 MySQL、PostgreSQL,或者直接写进 CSV 文件、阿里云 OSS、甚至 Redis 缓存里——每一步都在流程图里拖进来,连 SQL 语句都支持可视化拼接。插入前还能加个「过滤」节点,去掉重复项或空值。
- 遇到验证码或图片文字?装上 OCR 插件,上传截图就能返回识别结果,整个过程嵌在爬虫流程里,不需要切窗口、不中断运行。插件内置 Tesseract 引擎,也支持对接百度/腾讯等第三方 API。
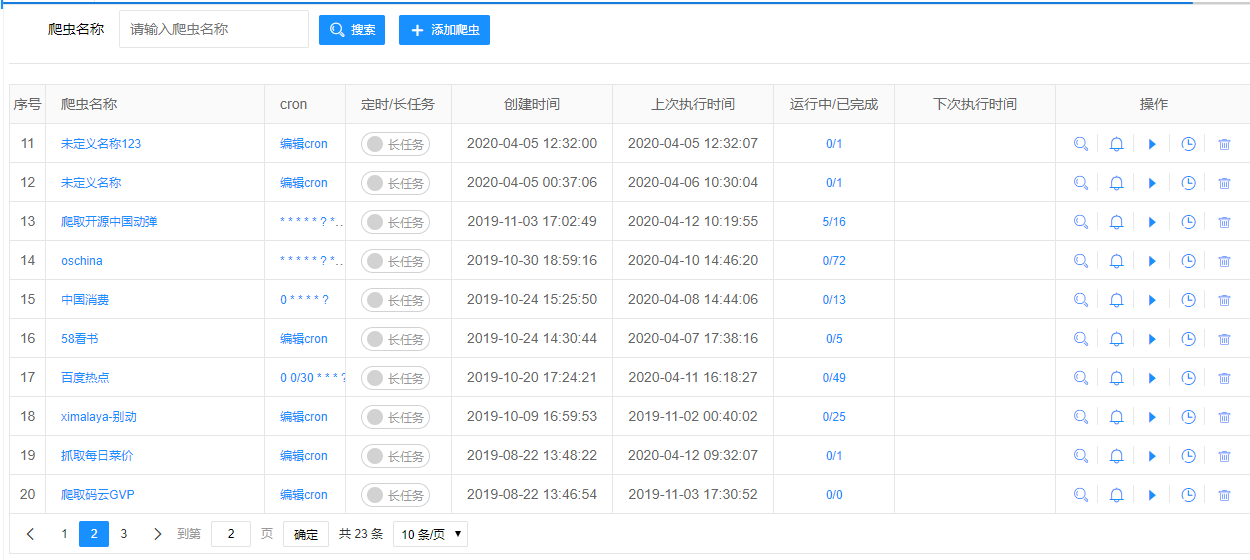
- 任务不是黑盒。每个爬虫都有独立日志、执行时间、失败原因和返回数据预览;还能设置 HTTP 接口,让其他系统一键触发或查询结果,像调用一个内部 API 那样简单。接口路径由你自定义,例如 /api/v1/job/start?name=news_crawl。
- 代理和 Cookie 全托管。平台自动管理会话状态,支持轮换 IP 代理池插件,你只管填好账号密码或接口地址,剩下的登录态维持、失效重试都由系统兜底。Cookie 过期后,自动触发登录流程重新获取。
怎么开始用

- 去 GitHub Releases 页面 下载最新版压缩包(文件名带 spider-flow-x.x.x.jar),解压后得到一个 JAR 文件和配置目录。配置目录里包含 application.yml,可修改端口、数据库连接、默认管理员密码等。
- 确保电脑已安装 Java 11 或更高版本(官网有下载链接),然后在终端里执行 java -jar spider-flow-x.x.x.jar;首次启动会自动生成配置并提示访问 http://localhost:5000。如果 5000 端口被占,可在启动命令后加 –server.port=5001 指定新端口。
- 打开浏览器,用默认账号 admin/admin 登录,首页就能新建流程图,拖入「HTTP 请求」节点,配上网址,再拖个「XPath 提取」节点连上去,点「测试运行」,数据就出来了。右键节点还能快速复制、删除、查看文档说明。
项目信息
新一代爬虫平台,以图形化方式定义爬虫流程,不写代码即可完成爬虫。
⭐
11.4k
11.4k
Stars
🔀
2.2k
Forks
2.2k
Forks
Java
📄
MIT
MIT