你有没有过这种时候:收到一份带复杂排版的 PDF,想把里面的数据粘进 Excel,结果复制出来全是错行、乱码、空格堆成山?
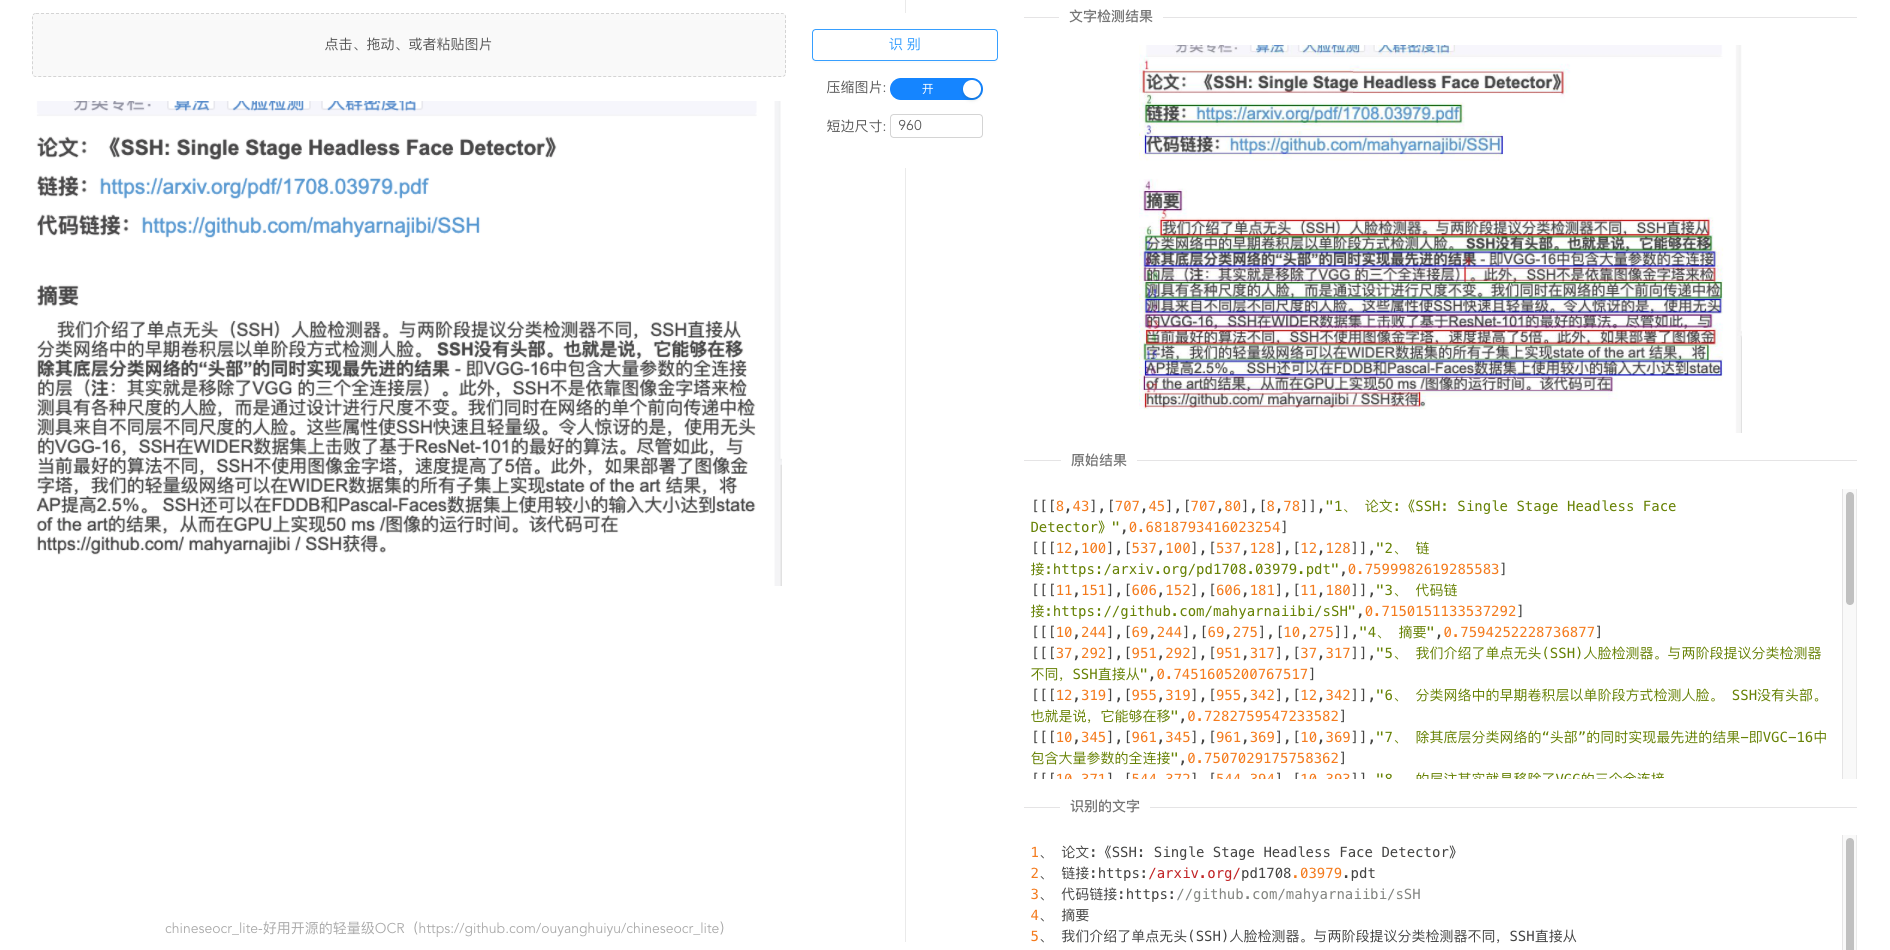
或者手头有张扫描件,上面是财务报表、课程表、合同条款——你只想提取文字,但主流 OCR 工具要么识别不准,要么直接把表格拍成一坨文字塞给你。
你其实不缺工具,缺的是「能看懂文档视觉结构」的那一个。
比如一页横向排版的资产负债表,左边是科目名称,右边是三列数值。传统 OCR 只会按从左到右、从上到下的顺序硬读,结果把“货币资金”和“2023年期末”挤在同一行,后面跟着“2022年期末”又跳到下一行。
而人眼一看就知道:这是表格,有列对齐,有跨页标题,有合并单元格。真正需要的不是“字在哪”,而是“这块内容在整页里扮演什么角色”。
能替代什么 / 能省多少钱
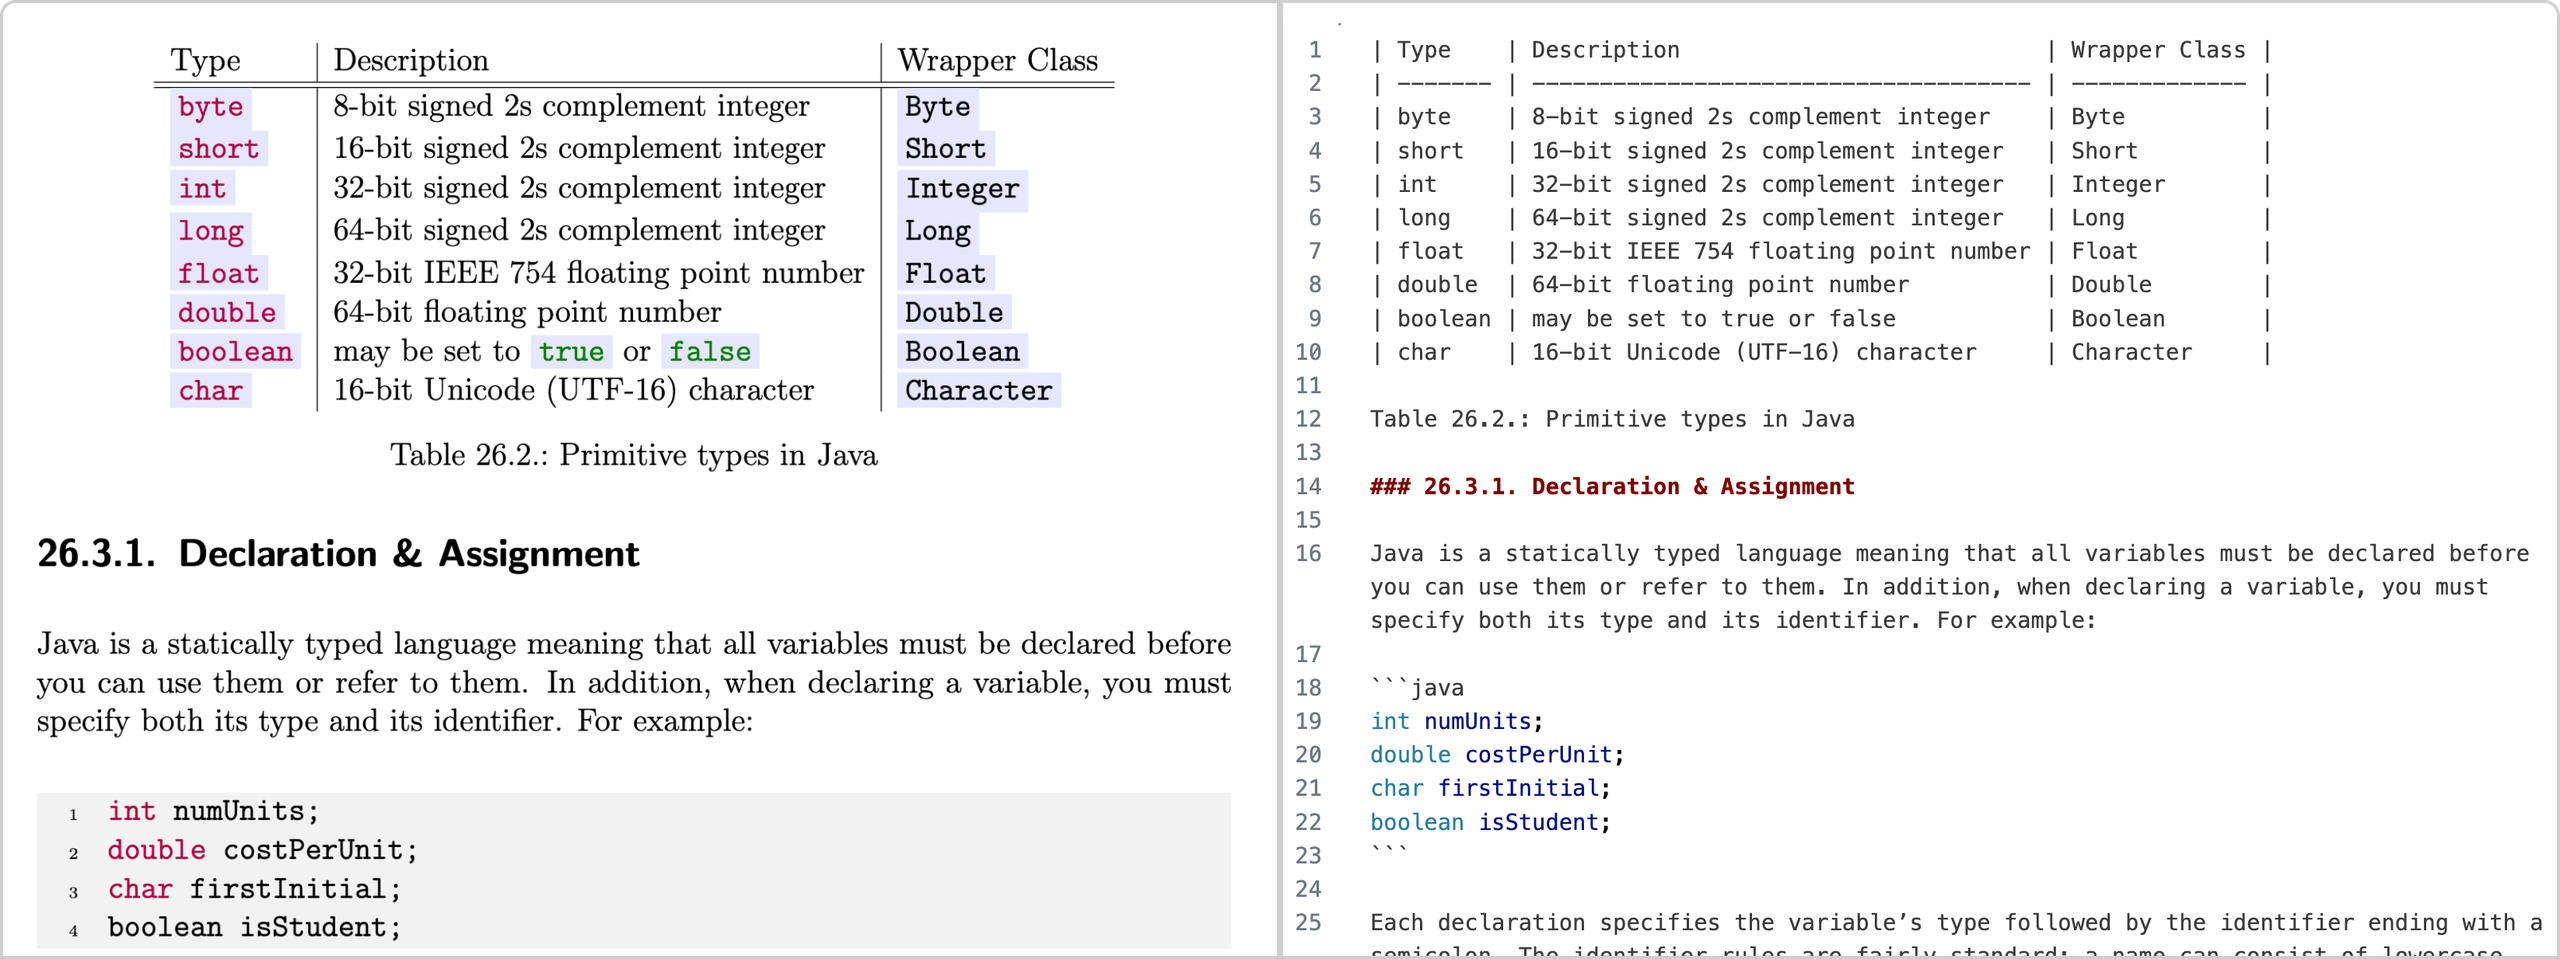
它不卖软件,也不收年费。但它干的是过去得靠Adobe Acrobat Pro + ChatGPT 手动粘贴才能搞定的事:把 PDF、扫描图、甚至 DOCX 里的真实排版,原样转成可编辑的 Markdown。
“文档是视觉的,不是纯文本的”——这是它所有功能的出发点。
你不用再为单次 PDF 表格识别付 99 元/月的订阅费,也不用买高价 OCR 插件去对付带图、带公式的文件。官方没标价格,但它的能力边界,已经踩进了商业 OCR 服务最贵的那块地。
价格直接砍到零。
它不替代专业排版软件,但能绕过那些“必须先转 Word 再调格式”的中间步骤。比如高校老师整理历年试卷题库,PDF 里混着公式、图注、多栏排版,用它跑一遍,就能得到带 $$ 包裹的 LaTeX 数学式、带  的图引用、以及正确嵌套的 `
- ` 列表。
它能干什么
- 把扫描件 PDF 当成一张张图喂给大模型,让 GPT 或 Gemini 去“看图说话”,输出带标题、列表、表格结构的 Markdown,不是简单识别字,而是理解哪里是表头、哪里是备注、哪段该缩进。例如识别出 `
` 标签后自动补上 |—|—| 分隔线,而不是把表格内容压成连续段落。
- 支持 PDF、DOCX、JPG、PNG 等常见格式,连带水印、斜着扫的页面也能自动扶正,不用你手动旋转再重传。背后调用的是 correctOrientation: true 参数,基于图像边缘检测判断倾斜角度,再做仿射变换校正。
- 你可以指定只处理第 3 到第 5 页,也可以让每一页都单独生成一段 Markdown,方便后续做分页比对或人工校验。对应参数是 pagesToConvertAsImages: [3, 4, 5](Node)或 select_pages=[3, 4, 5](Python)。
- 如果你要提取固定字段(比如合同里的甲方、签约日期、金额),它支持用 JSON Schema 定义结构,直接返回结构化数据,跳过中间的手动整理环节。Node 版用 schema 字段传入,例如 { “type”: “object”, “properties”: { “partyA”: { “type”: “string” } } }。
- 它不强制你用 OpenAI,Azure、AWS Bedrock、Google Gemini 都能接,只要你有对应 API Key,就能用自己的账号跑,数据全程不出你的电脑。配置时只需在 credentials 对象里填 apiEndpoint 和 apiKey,不同服务商的 endpoint 地址在文档里列得清清楚楚。
- Linux 下装起来特别干脆:一行命令装 Node 包,再一行命令装 graphicsmagick,之后就只管扔文件进去,连配置界面都没有。Windows 用户需额外装 Ghostscript,Mac 用户可用 brew install graphicsmagick ghostscript 一步到位。
怎么开始用
- 打开 GitHub 页面,点右上角绿色按钮 “Code” → “Download ZIP”,解压后双击运行(Linux 用户需先执行 sudo apt-get install -y graphicsmagick)。
- 注册一个免费的 OpenAI 或 Gemini 账号,拿到 API Key;把它填进配置文件或环境变量里,名字叫 OPENAI_API_KEY 或 GEMINI_API_KEY。注意:Key 必须带 sk- 或 AIzaSy 前缀,否则会报认证失败。
- 在终端里执行命令:npx zerox –filePath ./my-doc.pdf,等几秒,结果就输出成 Markdown 文本了,你可以直接复制进 Obsidian、Typora 或微信文档里编辑。如果想保存到文件,加个 –output ./out.md 参数就行。
- 遇到模糊扫描件?试试加 –imageDensity 400 提高截图精度;担心内存爆掉?用 –concurrency 3 限制同时处理页数;想保留原始图片用于复核?关掉 –cleanup 开关。
项目信息
OCR & Document Extraction using vision models
本网站所提供的所有资源(包括但不限于软件、文档、教程、代码、素材等)均收集自互联网公开渠道,仅供个人学习、研究及交流使用。我们无法对所有资源的版权归属进行逐一核实。
OPENKLC昆仑草-免费资源下载-源码下载 开源易选 它不靠传统 OCR 引擎,靠的是让 AI “看图写话 https://www.openklc.com/3711.html
 常见问题
相关文章
猜你喜欢- 它不靠传统 OCR 引擎,靠的是让 AI “看图写话 2026-10-23
- 每月花 800 元租 NAS 云盘?ZeroFS 让你用 S3 自建同款 2026-10-23
- 你再也不用把截图发给朋友问“这张图里写了啥 2026-10-23
- Star数2821,安装只要一行Docker命令 2026-10-22
- 5403 颗星,界面却只有 1 个画布和 3 个导出按钮 2026-10-22
- 你每年为读书APP会员、TTS服务、笔记同步多付的298元,其实早被这个开源工具包圆了 2026-10-22
- 它没中文界面,但国内不少小团队已把它当主力网关用了 2026-10-22
- 以后查公开推文,你再也不用打开网页手动翻页了 2026-10-22
- Star 数2653,安装包不到20MB,双击即用 2026-10-22
- 你有台吃灰的树莓派,现在它能变成你全家人的私有云盘 2026-10-21
OPENKLC 昆仑草
交流群
您的支持,是我们最大的动力! QQ交流群:
 热门文章热门评论热门标签
- 把扫描件 PDF 当成一张张图喂给大模型,让 GPT 或 Gemini 去“看图说话”,输出带标题、列表、表格结构的 Markdown,不是简单识别字,而是理解哪里是表头、哪里是备注、哪段该缩进。例如识别出 `