你是不是也这样:注册个网站、登录个老系统、查个社保,卡在验证码上——放大、歪头、反复试错、最后点“换一个”再重来。
光是去年,我粗略算过,平均每天为验证码多花2分17秒。一年下来,就是13小时。这还没算输错三次被锁住、重新填表单的崩溃感。
有些验证码根本不像字:带干扰线、扭曲字母、彩色叠层、甚至中文+数字混排。你不是不会打字,是它不让你打字。
还有些场景根本没法绕开:单位内网系统没API、政务平台禁用自动化、银行登录强制人机验证……这时候,你连付费接口都调不了。
不是所有验证码都该被破解,但真该由你自己决定——哪张图要识别、哪次请求该放行、哪些数据永远留在本地。
能替代什么 / 能省多少钱
它不卖软件,也不收年费,但干的是付费验证码识别服务的活儿。比如「超级鹰」这类平台,按次收费,识别一次几毛到一块不等;月付套餐起步也要几十块。
数据全程不出你的电脑。
而 ddddocr 是纯本地运行的离线工具,图片进、文字出,中间不上传、不联网、不走第三方服务器。你截个图,它就认,不用开网页、不用填API密钥、不用等返回。
价格直接砍到零。
更重要的是控制权:你可以把识别逻辑嵌进脚本里自动填表,也可以集成进爬虫做批量查询,甚至写成小工具给同事用,没有调用频次限制,没有IP白名单审核,也没有突然涨价或停服通知。
它能干什么

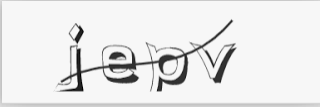
- 识别各种乱七八糟的验证码图片:数字+字母组合、中文汉字、大小写混排、带干扰线或噪点的图,只要截图清晰,基本一试就中。官方说训练用了大批量随机生成数据,不是靠人工标注堆出来的。实际支持的字符集默认包含 0-9、a-z、A-Z、常用汉字及部分符号,覆盖绝大多数国内网站验证码。
- 滑块验证码也能解:比如“把缺口拖到正确位置”这种,它能自动比对两张图的边缘差异或像素偏移,算出该滑多少像素。不需要你手动找缺口,更不用模拟鼠标轨迹。内部提供两种算法:一种基于Canny边缘检测匹配轮廓,一种通过逐像素差值定位最大偏移区域,调用时只需传入两张图路径即可。
- 支持自定义字符范围:如果你只处理某类固定格式的验证码(比如全是4位纯数字),可以限定只识别0-9,准确率会更高。文档里明确写了怎么配 charsets_path 参数,新建一个JSON文件,内容是 [“0″,”1″,”2″,…,”9”],初始化时传入路径即可生效。
- 能跑在你手头这台机器上:Windows、Mac(包括M1/M2芯片)、主流Linux发行版都支持。Python 3.6 到 3.12 都行,没提兼容性问题,这点得自己确认。ARM64架构用户注意:需安装对应版本的onnxruntime,不能直接用x86的wheel包。
- 初始化快,调用简单:一行代码加载模型,一行传图识别。示例里连“读图→识别→打印结果”才三行,没封装、没抽象、没多余依赖。连PIL都不用装,它自带图像解码逻辑,支持PNG/JPEG/BMP/GIF(静态帧)。
- 可选GPU加速:如果你有N卡且装了CUDA,加个 use_gpu=True 就能提速。不过文档也老实说了:没装对应环境会初始化失败,不是静默降级。显存占用约1.2GB起步,适合GTX1060及以上显卡。
上手只要三步
- 先确认你电脑已装好 Python(3.6 及以上),没有的话去 python.org 下载安装包,勾选“Add Python to PATH”,双击运行就行;
- 打开命令行(Windows 按 Win+R 输入 cmd,Mac 打终端),粘贴这行:pip install ddddocr,回车执行,通常1分钟内装完;
- 新建一个文本文件,后缀改成 .py,粘贴官方给的最简示例代码(5行以内),双击运行,它就会弹出识别结果,不用改任何配置。
示例代码长这样:
import ddddocr
ocr = ddddocr.DdddOcr()
with open(‘captcha.png’, ‘rb’) as f:
img_bytes = f.read()
res = ocr.classification(img_bytes)
print(res)
项目信息
带带弟弟 通用验证码识别OCR pypi版
⭐
14.8k
14.8k
Stars
🔀
2.4k
Forks
2.4k
Forks
Python
📄
MIT
MIT