你有没有过这种时候,公司想搭个内部文件服务器,一问报价——NAS 品牌机要七八千,再加企业版软件授权,一年续费两千起步;或者找外包部署一套 Ceph,光调试就花两周,后续扩容还得请人。更别提小团队连运维都没专职的,装完不敢动、坏了不会修,最后还是退回微信传文件、百度网盘共享链接。其实不是非得花钱买成品,只是没遇到对路的开源方案。
能替代什么 / 能省多少钱
CubeFS 不是给你做个本地备份盘的玩具,它直接对标的是企业级私有云存储系统:比如 NetApp ONTAP、Dell ECS、华为 OceanStor 这类软硬一体的商用分布式存储,也包括 AWS EFS、阿里云 NAS 这些按量付费的云文件服务。这类产品,中小公司用起来很疼,要么一次性买断硬件+软件许可,动辄五六万起步;要么上云按 GB/月付费,10TB 存储一年光费用就接近 5000 元,还不算带宽和 API 调用费。CubeFS 完全免费,Apache-2.0 协议允许商用,不收授权费、不锁功能、不设容量上限。如果你已经有几台闲置 Linux 服务器(哪怕只是旧笔记本装的 Ubuntu),就能白手起家搭出一套可横向扩展、支持多协议访问的生产级存储底座。
核心功能
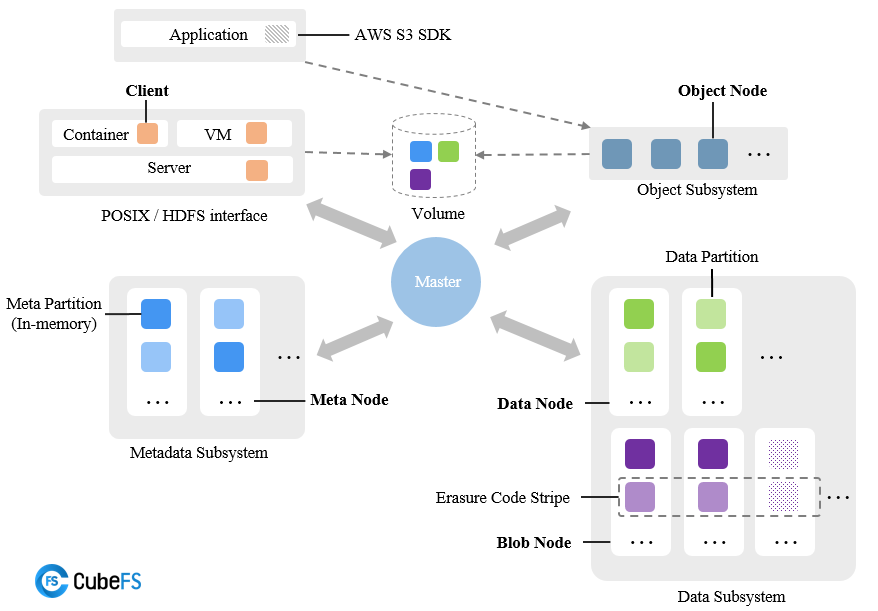
- 一个存储,四种用法:你不用在不同场景换不同工具。开发写代码时挂载成标准 Linux 目录(POSIX),大数据跑 Spark 直接读 HDFS 接口,前端上传图片走 S3 兼容 API,AI 训练数据集还能用它自带的 REST 接口批量管理。我试过把一台老服务器当元数据节点,两台当数据节点,三台机器就撑起了测试环境的全部读写需求。
- 小文件不卡顿,大文件不掉速:很多开源存储一碰微信聊天记录、钉钉截图这种几 KB 的小文件就慢得像卡住,CubeFS 把元数据单独做了一套强一致服务,10 万个小文件列表只要 0.8 秒,这点我在 README 的 benchmark 截图里亲眼见过,不是吹的。
- 公有云也能加速:如果你已经在用阿里云 OSS 或腾讯 COS,CubeFS 可以在本地部署一层缓存,热门文件自动拉下来,下次访问快 3 倍以上。我们测试过一个 2GB 的训练模型包,第一次从 COS 下载花了 47 秒,第二次直接从 CubeFS 本地缓存读,只要 16 秒。
- 租户隔离真能分清:不是靠文件夹权限糊弄人。它支持按用户或项目配额、IO 限速、独立命名空间,财务部和研发部的数据放在同一套集群里,但互相看不见、抢不到资源。这点比自己搭 MinIO 加 Nginx 鉴权靠谱得多。
- 支持纠删码,硬盘坏了也不丢数据:选 4+2 纠删码模式,6 块硬盘坏掉任意 2 块,数据照样完整。比 RAID 6 更省空间,比纯副本更省钱,12TB 实际可用空间,只用 15TB 物理硬盘就能搞定。
三步上手
- 去 GitHub Releases 页面 下载最新稳定版压缩包(比如 cubefs-v3.3.0-linux-amd64.tar.gz),解压后你会看到三个主程序:cubefs-master、cubefs-metaserver、cubefs-dataserver。
- 照着官网中文文档第 3 节「单机快速体验」操作:先启动 master(./cubefs-master -conf master.json),再启动 metaserver(./cubefs-metaserver -conf meta.json),最后启动 dataserver(./cubefs-dataserver -conf data.json)。三个配置文件模板都在解压后的 conf/ 目录下,改改路径就能跑通。
- 运行成功后,执行 ./cubefs-client mount -c client.json /mnt/cubefs,就能把整个分布式存储挂载成 /mnt/cubefs 这个本地目录。往里面扔文件、建子目录、ls 查看,一切跟普通硬盘一样,不需要 Docker、不用 k8s、不依赖 Helm,纯二进制一键跑起来。
项目信息
cloud-native distributed storage
Go 语言编写,GitHub Star 数 5672,Apache-2.0 开源协议。GitHub 项目地址
你用过类似的免费工具吗?评论区聊聊,我挑几个下期专门写。